瀏覽代碼

init: 做课系统 v2 —— llm-wiki 式课程知识库

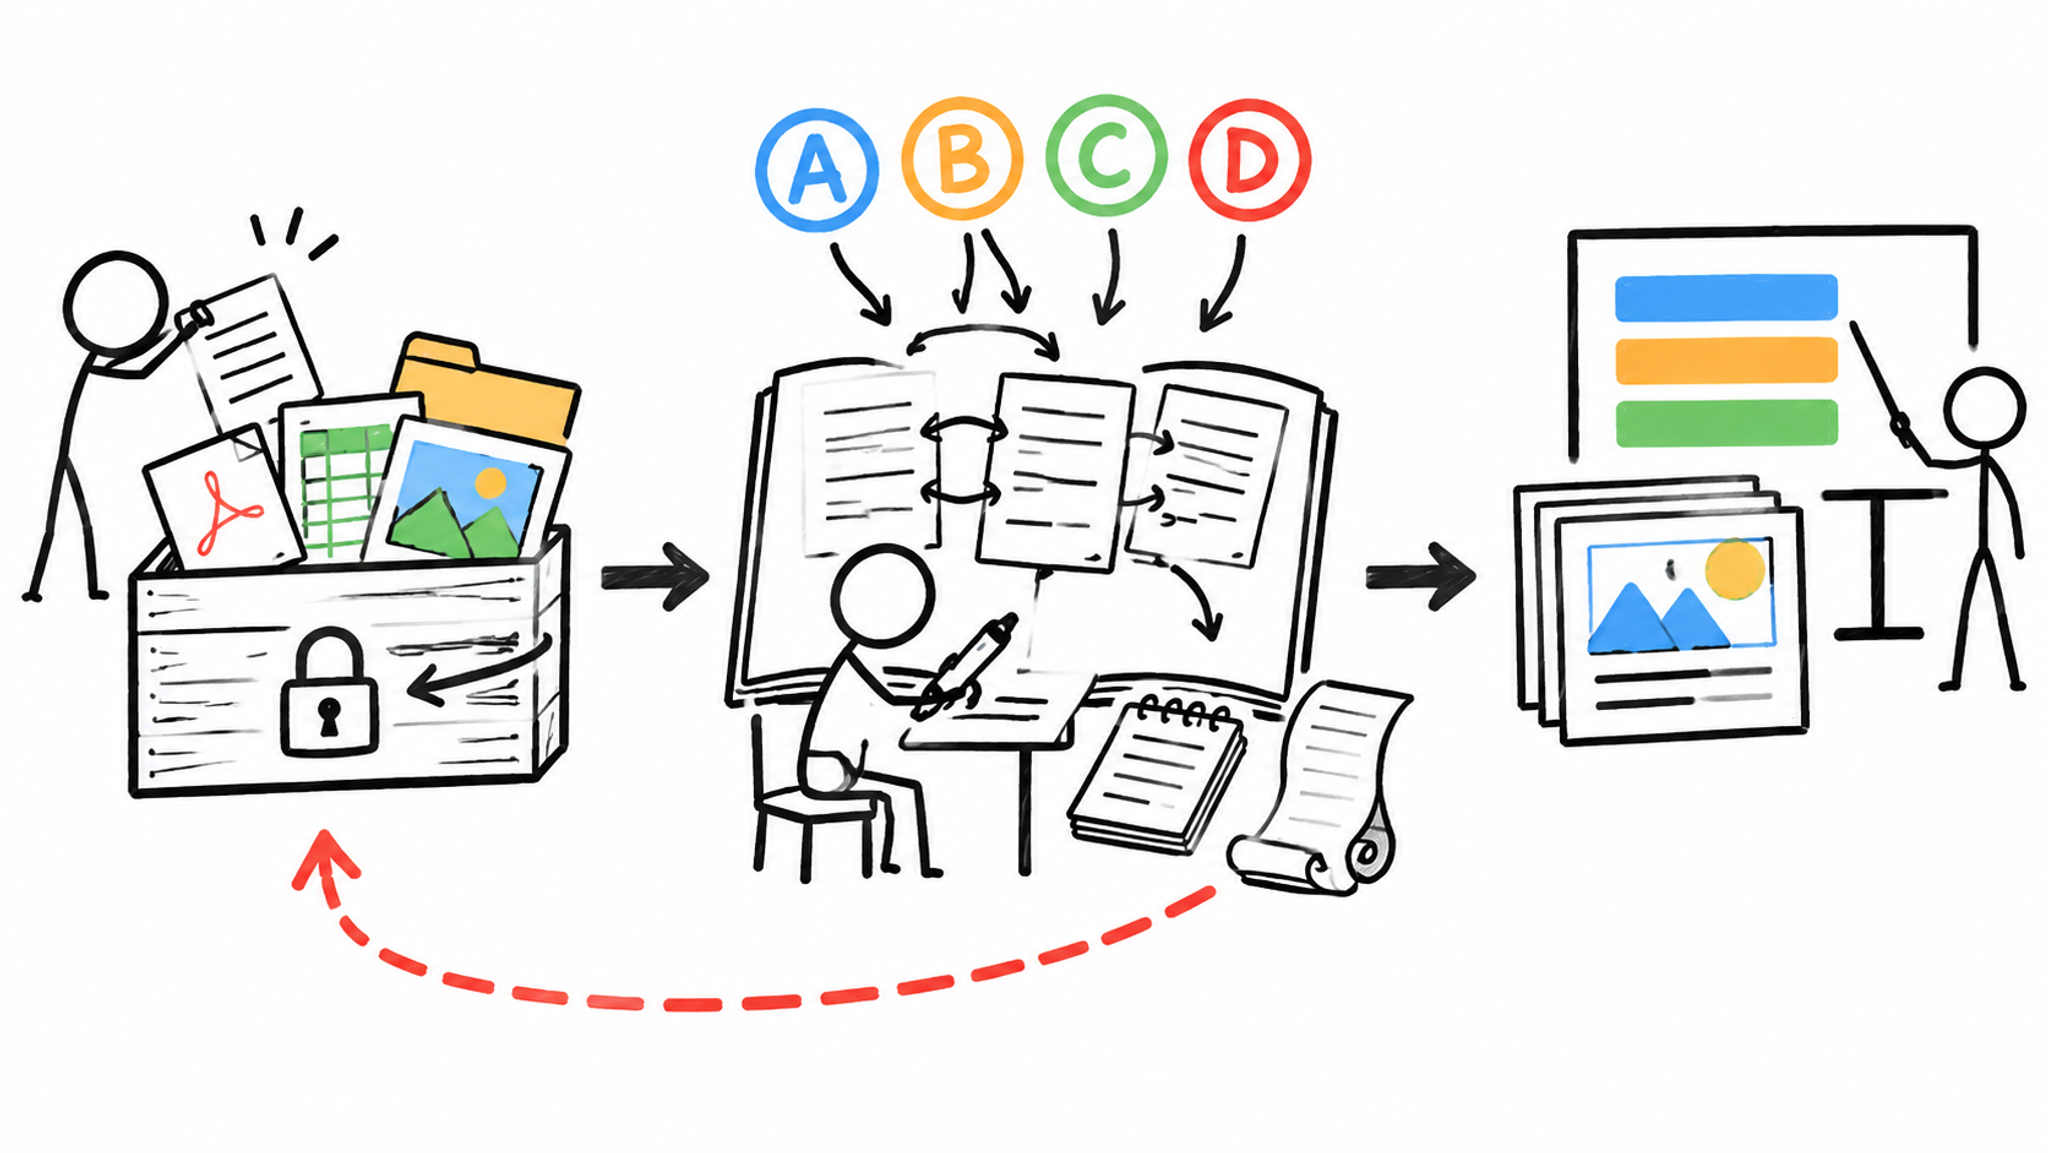
三层架构:原材料(只进不改)/ 知识库(全 md,LLM 维护)/ 契约(约定.md)
四条机制:指纹增量 · 三档回滚 · 三层索引 · 证据分级 A/B/C/D
八项技能:course-factory 总入口,kb-sync/ingest/query/lint/index,course-outline/slides
两个检查器:kb.py lint 管结构,check-content.py 管内容
参考:Karpathy llm-wiki · lucasastorian/llmwiki · eternity4719/HowToLiveBetter
shencp 14 小時之前
當前提交
92148a3ebc

+ 30 - 0
.gitattributes

@@ -0,0 +1,30 @@
+# 统一按 LF 存进仓库,避免 Windows / macOS 换行符互刷
+* text=auto eol=lf
+
+# 文本类:diff 才有意义
+*.md    text eol=lf
+*.py    text eol=lf
+*.html  text eol=lf
+*.json  text eol=lf
+*.jsonl text eol=lf
+*.yml   text eol=lf
+*.yaml  text eol=lf
+
+# 二进制:不做 diff,不做换行转换
+*.png  binary
+*.jpg  binary
+*.jpeg binary
+*.webp binary
+*.gif  binary
+*.pdf  binary
+*.docx binary
+*.doc  binary
+*.pptx binary
+*.ppt  binary
+*.xlsx binary
+*.xls  binary
+*.mp3  binary
+*.mp4  binary
+
+# changelog.jsonl 是只追加的,合并时优先保留两边的内容
+10-知识库/_meta/changelog.jsonl merge=union

+ 27 - 0
.gitignore

@@ -0,0 +1,27 @@
+# Python
+__pycache__/
+*.py[cod]
+.venv/
+
+# 系统垃圾
+.DS_Store
+Thumbs.db
+desktop.ini
+
+# Office / 浏览器临时文件(同步时也会被 kb.py 忽略,这里再挡一层防误提交)
+~$*
+*.tmp
+*.crdownload
+*.part
+
+# 工具临时产物
+_assets/_preview.html
+_assets/shot*.png
+10-知识库/_meta/*.bak
+
+# ---------------------------------------------------------------
+# 刻意不忽略、必须进版本控制的东西(别加进来):
+#   10-知识库/_meta/manifest.json   丢了会丢「已整理」状态
+#   10-知识库/_meta/*.jsonl         关系图和历史都在这
+#   00-原材料/                       唯一真相源,最该被保护的东西
+# ---------------------------------------------------------------

+ 0 - 0
10-知识库/_meta/derivations.jsonl


+ 7 - 0
10-知识库/_meta/manifest.json

@@ -0,0 +1,7 @@
+{
+  "version": 2,
+  "root": "00-原材料",
+  "updated_at": null,
+  "files": {},
+  "tombstones": []
+}

+ 70 - 0
10-知识库/_meta/矛盾登记.md

@@ -0,0 +1,70 @@
+# 矛盾登记
+
+> 两份资料说法不一致时,**不许静默采用新的那一份**。登记下来,做一次裁决,写明理由。
+
+---
+
+## 为什么必须有这个文件
+
+知识库最危险的状态不是"缺内容",是**两份互相打架的内容并存,而没人知道**。
+
+做课时引用了哪一份,全凭运气。更糟的是:新人看到 A 页写"市场 380 亿",B 页写"市场 210 亿",会以为是自己理解错了。
+
+Karpathy 在 llm-wiki 里把「new data contradicts old claims」列为 lint 第一项,理由是:一个不处理矛盾的 wiki,规模越大越不可信。
+
+---
+
+## 登记表
+
+| 登记日 | 冲突点 | 说法 A(来源 · 等级) | 说法 B(来源 · 等级) | 裁决 | 状态 |
+|---|---|---|---|---|---|
+| _(示例)_ 2026-11-04 | 企业 AI 培训市场规模 | 380 亿(某白皮书 · B) | 210 亿(行业年报 · B) | 取 380 亿,口径含 IT 培训;210 亿仅指管理培训 | 已裁决 |
+
+---
+
+## 规则
+
+### 什么时候登记
+
+入库(`kb-sync`)或检索(`kb-query`)时,只要发现**同一件事有两种说法**,就登记。包括:
+
+- 数字不一致(最常见,也最危险)
+- 结论相反("应该先做 X" vs "不要先做 X")
+- 时间口径不同(2024 年数据 vs 2026 年数据,看起来矛盾其实是时效差)
+- 适用范围不同("中小企业适用" vs "只适合大企业")
+
+### 怎么裁决
+
+三选一,**必须选一个,不许挂着**:
+
+| 裁决 | 适用 | 后续动作 |
+|---|---|---|
+| **采用 A** | A 的口径更清楚、来源更强、更新更近 | 把 B 的说法从页面里删掉,或在正文注明「另一种口径是 X,已不采用,理由见矛盾登记」 |
+| **采用 B** | 同上,反过来 | 同上 |
+| **都采用,写明条件** | 确实都成立,只是适用范围不同 | 页面里两句话并存,但必须紧跟「前者适用于…,后者适用于…」 |
+
+**裁决后,页面上不能有两句话并存而没有任何说明。** 那等于把问题丢给读者。
+
+### 状态
+
+- `待裁决` —— 已登记,还没定。**这时候这页不能用于做课**(课件里不许出现待裁决的数字)
+- `已裁决` —— 定了,页面已按裁决改完
+- `已消解` —— 源更新后矛盾自然消失(比如旧文件被删了)
+
+### 谁来裁决
+
+数字口径类:谁最懂这块业务谁定,通常是做课的人。
+法条、政策类:只认官方原文,以官方最新版为准,不裁决直接替换。
+客户数据类:以客户书面提供的为准,口头说法登记为 C 级备注。
+
+---
+
+## 和 lint 的关系
+
+`kb.py lint` **查不出**矛盾 —— 这需要读懂两段话的意思,脚本做不到。
+
+所以矛盾只能靠两处兜住:
+1. **入库时**:`kb-ingest` 有一项检查「本页结论是否和已有页冲突」
+2. **体检时**:`kb-lint` 的每月任务里有一条「抽 5 个 topic 页,对比它们的数字是否互相矛盾」
+
+这是这套系统里少数需要人(或 LLM 语义判断)而非脚本的地方。承认它,比假装能自动检查更好。

+ 199 - 0
10-知识库/_meta/约定.md

@@ -0,0 +1,199 @@
+# 知识库契约(宪法)
+
+> 本文件定义本库所有 md 文件的格式约束。`kb.py` 与所有 skill 都以此为准。
+> 改本文件 = 改法律:必须同步改 `90-工具/kb.py` 的 `dump_fm` 字段顺序,并在文末「规则变更记录」登记。
+
+---
+
+## 一、四类页面
+
+| 类型 `type` | 目录 | 职责 | 一页装什么 |
+|---|---|---|---|
+| `source` | `sources/` | **来源页**:一个原材料文件对应一页 | 该文件讲了什么、关键事实、可引用原句、适用场景 |
+| `topic` | `topics/` | **主题页**:多源合成的知识块 | 一个业务问题下的整合结论(市场规模、客户画像、方法论体系) |
+| `entity` | `entities/` | **实体页**:人/机构/工具/政策/术语 | 该实体的定义、属性、与本业务的关系 |
+| `module` | `modules/` | **课程模块**:可直接进课程的最小单元 | 目标、知识点、案例、时长、素材出处、练习 |
+
+**判定规则**
+- 有唯一物理源 → `source`
+- 由 ≥2 个源综合得出 → `topic`
+- 有专有名词、需要被反复引用 → `entity`
+- 能直接搬进课表 → `module`
+
+一个源文件通常派生 **1 个 source 页 + 若干个 topic/entity/module 页**。
+纯废话的源文件可以只建 source 页,不强行派生。
+
+---
+
+## 二、frontmatter 字段
+
+```yaml
+---
+id: "src_a1b2c3d4"        # 唯一 id,source=src_*,topic=tp_*,entity=en_*,module=md_*
+type: "source"             # source | topic | entity | module   【必填】
+title: "2026 AI 培训白皮书"  # 人类可读标题                                【必填】
+summary: "一句话说明这页有什么用"  # ≤ 40 字,进索引            【必填】
+evidence: "A"              # A|B|C|D 证据等级,见第三节          【必填】
+tags:                      # 2–5 个,用于检索
+  - "行业"
+  - "市场"
+sources:                   # 【关键】该页内容来自哪些原材料
+  - "01-行业资料/2026-AI培训白皮书.pdf"
+related:                   # 相关页面的 stem(不含 .md)
+  - "提示词案例集"
+status: "active"           # active | draft | archived
+stale: false               # true = 上游变了,本页待重建
+stale_reason: ""           # 为什么 stale
+created: "2026-11-04"
+updated: "2026-11-04"
+---
+```
+
+### sources 字段是回滚机制的全部依据
+
+- 值 = **原材料在 `00-原材料/` 下的相对路径**(POSIX 斜杠),不是 id、不是文件名。
+- 必须精确,一字不差。`kb.py retract` 靠它定位要回滚的页面。
+- 一个页面可以有多个源(共享页);只有一个源的叫独占页。二者的删除行为不同。
+
+---
+
+## 三、证据分级(每页必标)
+
+做课最大的风险不是没内容,是**把 C 级经验当成 A 级数据讲给客户听**。学员一追问就穿帮。
+
+| 级别 | 定义 | 典型来源 | 讲课时的约束 |
+|---|---|---|---|
+| **A** | 可核验的一手数据,有明确口径和出处 | 国家统计局、上市公司财报、客户书面提供的真实数据、已发表的一手研究 | 可直接讲,页脚标出处 |
+| **B** | 有研究或报告支撑,但样本小、口径不明、无法复现 | 咨询公司白皮书、行业调研、单一案例报告 | 必须说「某机构测算」,不能说「数据显示」 |
+| **C** | 从业者经验、普遍共识,无直接证据 | 讲师判断、同行说法、行业习惯 | 必须说「经验上」,不能当结论用 |
+| **D** | 推断、假设、未验证 | 「我推测客户会在意…」、模型生成的分析 | **不许进课件**,只能留在 module 的「待验证」区 |
+
+### 木桶规则
+
+**页面的 `evidence` = 该页所有内容里最弱的那一条。**
+
+- `source` 页:按原文件本身的性质定级。
+- `topic` 页:**不得高于**它所有 `sources` 对应 source 页的最低级。合成不会提高证据强度。
+- `module` 页:不得高于它引用的素材最低级。
+- `entity` 页:无权威来源时一律 `C`。
+
+`kb.py lint` 会查 `EVIDENCE_INFLATED`(声明等级高于来源最低级),这是本库最容易被糊弄过去的一项。
+
+### 做课的硬配比
+
+- 讲授内容里 **A + B 不低于 60%**,否则整门课是"讲师个人经验分享"。
+- **D 级一律不上课件。**
+- 单个模块如果只有 C 级素材,必须在模块详案里写明「本模块以经验为主,建议补一份 A/B 级材料」,并进 `03-缺口与补料.md`。
+
+---
+
+## 四、溯源规则
+
+正文中任何**具体数字、论断、引语**后面加脚注引用对应 source 页:
+
+```md
+2026 年企业 AI 培训市场规模达 380 亿元。[^白皮书]
+```
+
+- 脚注标签用 source 页的 stem,LLM 与人都能对上。
+- 不确定的说法必须标注「(推测)」或「(待核实)」,不允许把推测写成事实。
+- **带 `万 / 亿 / % / 倍 / 元 / 人` 的数字,前后 100 字内必须有出处**(脚注、双链、或 `来源:` 字样)。`check-content.py` 机器查这一条。
+
+---
+
+## 五、写作规则
+
+1. **原子性** — 一页只讲一件事。想写第二件事就开新页。
+2. **结论先行** — 每页开头 3 行内给出结论,细节在后。
+3. **可独立阅读** — 打开这一个 md 就能看懂,不依赖上下文。
+4. **链接用 `[[stem]]`** — 双链,不带 `.md`。指向不存在的页面会被 lint 报 DEAD_LINK。
+5. **不写"本文介绍了…"** — 直接写内容。
+6. **中文正文,英文专有名词保留原样**。
+7. **长度** — source 页 200–800 字;topic 页 300–1500 字;module 页 200–600 字。低于 100 字判为 THIN。
+
+### 反 AI 腔(`check-content.py` 机器查)
+
+下面几种是 AI 写知识库时的固定病,见到就改:
+
+| 病症 | 例子 | 改法 |
+|---|---|---|
+| **元叙述** | 「本页介绍了…」「这条主要讲…」「以上就是…」 | 删掉这一句,直接写内容 |
+| **空转加强词** | 「值得注意的是」「本质上」「总而言之」「不难发现」 | 直接删,不损失信息 |
+| **段尾升华** | 「让我们一起拥抱 AI 时代」「未来可期」 | 删 |
+| **万能开头** | 「在当今快速发展的…背景下」「随着…的不断发展」 | 直接说事 |
+| **要读者翻译的比喻** | 「这套组合拳」「打通最后一公里」「形成护城河」 | 换成具体动作 |
+| **电报体** | 一句话一个句号,句句十来个字,读着像念提纲 | 有因果/转折的相邻短句用「因为/所以/但」连起来 |
+
+**句子标准**:一句一件事,30 字上下,最长不超过 60 字。超过 60 字的句子 `check-content.py` 会列出来。
+
+### 写给人看,不是写给模型看
+
+读者是公司里要去做课的同事,不是 AI。所以:
+
+- 专业名词当场用一句日常话解释,名词本身保留(「Agent 编排,也就是让几个 AI 分工干活」)。
+- 不写只有同行看得懂的缩写。
+- 每句话单独拿出来能读懂。需要回看上文才懂的句子,重写。
+
+---
+
+## 六、stale 的含义
+
+页面被标 `stale: true` 表示**内容可能已过期,读之前先看 stale_reason**。
+
+产生 stale 的三种情形:
+| 情形 | 触发者 | 处理方式 |
+|---|---|---|
+| 源文件被删除,但页面还有其他源 | `kb.py retract` | 用剩余源重新合成,清掉 stale |
+| 源文件内容变更 | `kb-sync` | 重读源,更新页面 |
+| 引用的下游页面失效 | `kb.py retract` 级联 | 人工确认后决定改写还是解除引用 |
+
+处理完必须清 `stale: false` 并删掉 `stale_reason`,否则下次 lint 还会报。
+
+---
+
+## 七、禁止事项
+
+- ❌ 不在 `10-知识库/` 里放非 md 文件(图片一律引用原文路径)
+- ❌ 不手动改 `_index.md`(`kb.py graph` 会覆盖)
+- ❌ 不在 `00-原材料/` 里修改或删除已入库的文件而不跑 `kb-sync`(会让 manifest 与磁盘脱节)
+- ❌ 不把 `sources:` 写成文件绝对路径或文件名
+- ❌ 不建只有标题没有内容的空页
+- ❌ 不给页面标高于其来源的 `evidence`
+- ❌ 不让两种说法打架还并存 —— 发现冲突必须登记 `_meta/矛盾登记.md` 并裁决
+
+---
+
+## 八、可重建性分级(决定备份什么)
+
+不是所有东西都值得备份,也不是所有东西丢了都能重来。分清这两件事,才知道该保护什么。
+
+| 东西 | 丢了能重建吗 | 怎么重建 |
+|---|---|---|
+| `00-原材料/` | **不能** | 这是唯一真相源,没有替代品 |
+| `_meta/矛盾登记.md` | **不能** | 裁决理由是人的判断,无法还原 |
+| `_meta/changelog.jsonl`、`CHANGELOG.md` | **不能** | 历史就是历史 |
+| `10-知识库/*/` 页面内容 | 勉强能 | 重读源让 LLM 重写,但历次「沉淀」出来的结论会永久丢失 |
+| `_meta/manifest.json` | 能 | `kb.py scan` 重算指纹,但「已整理」状态丢失,会当新文件重做一遍 |
+| `_meta/derivations.jsonl` | 能 | `kb.py graph` 从页面 frontmatter 重建 |
+| `*/_index.md` | 能 | `kb.py graph` |
+| `_meta/rebuild_queue.jsonl` | 能 | 从 `stale: true` 的页面重新推导 |
+
+**一句话**:只要 `00-原材料/` 还在,知识库永远能重建,只是很贵(几十小时 LLM 工时)。原材料没了,整个系统归零。
+
+**备份优先级**:原材料 > 矛盾登记 > changelog > 其余。前三个丢了不可逆,后面几个丢了只是费时间。
+
+---
+
+## 九、规则变更记录
+
+**每条新规则必须登记:什么时候加的、因为什么事加的、谁改的。**
+没有起因的规则,三个月后就会被人当成官僚条款删掉,然后同一个坑再踩一次。
+
+| 日期 | 改动 | 起因 |
+|---|---|---|
+| 2026-11-04 | 初版:四类页面 + frontmatter 契约 + 溯源 + stale | 做课系统搭建 |
+| 2026-11-04 | 新增第三节「证据分级」A/B/C/D + 木桶规则 + 做课配比;`evidence` 列为必填字段 | 参照 HowToLiveBetter 的条目证据分级。原设计只有 `sources` 没有可信度,做课时无法判断哪句话能直接讲、哪句要加限定语 |
+| 2026-11-04 | 新增第五节「反 AI 腔」与句子标准 | 同上,对应其 `check-plain.mjs`。知识库由 LLM 写,不设文风红线就会积累成"AI 生成的垃圾" |
+| 2026-11-04 | 新增第四节「带单位的数字必须有出处」 | 做课翻车都翻在数字上。结构完整的页面里塞一个没有出处的 42%,比缺页更危险 |
+| 2026-11-04 | 新增 `_meta/矛盾登记.md`;约定「两份资料说法不一致时不许静默采用新的」;新增第八节可重建性分级 | 参照 Karpathy llm-wiki 把「new data contradicts old claims」列为头号检查项。做课时最怕两份资料打架而无人知晓,引用哪份全凭运气 |
+| 2026-11-04 | kb-query 增加「第 6 步 沉淀」;kb-sync 增加「5.6 回声检查」;kb.py 新增 `guide` 命令与人读 CHANGELOG.md | 同上。Karpathy 的核心洞察是 wiki 要「复利」:①答过的分析要归档回库,否则每次从零拼;②一个源平均触及 10–15 页,只建 1 页等于漏了回声检查。`guide` 对应 llmwiki 的自描述入口,省 AI 重建认知的 token |

+ 6 - 0
10-知识库/entities/_index.md

@@ -0,0 +1,6 @@
+# 实体页索引
+
+> 自动生成于 2026-11-04T18:30:38+08:00,共 0 条。请勿手改,改页面 frontmatter 后重跑 `kb.py graph`。
+
+_(暂无内容)_
+

+ 81 - 0
10-知识库/index.md

@@ -0,0 +1,81 @@
+# 知识库总索引
+
+> 这是整库的**路由入口**。查东西先看这里,别一上来就全文搜索。
+> 各目录的明细索引在 `sources/_index.md`、`topics/_index.md` 等,由 `kb.py graph` 自动生成。
+> 本文件由 `kb-index` 技能维护,可以手改,但改完要跑一次 `kb.py graph` 校验。
+
+---
+
+## 我要做什么?
+
+| 我想… | 去这里 |
+|---|---|
+| 丢新资料进来 | `00-原材料/_inbox/`,然后说「同步知识库」 |
+| 看库里有什么 | 下面「业务地图」+ 各目录 `_index.md` |
+| 查某个主题 | 看「业务地图」→ 对应 topic 页 |
+| 找一份原始文件的摘要 | `sources/_index.md` 按文件名找 |
+| 做一门课 | 说「帮我做一门 XX 课」,走 `course-outline` |
+| 知道库是否健康 | 说「检查知识库」或跑 `python 90-工具/kb.py lint` |
+
+---
+
+## 业务地图
+
+> 按**业务问题**组织,不按文件组织。每新增一个 topic 页,在这里挂一行。
+
+### A. 市场与行业认知
+| 主题 | 页面 | 更新时间 | 可信度 |
+|---|---|---|---|
+| _(待填)_ | | | |
+
+### B. 客户与需求画像
+| 主题 | 页面 | 更新时间 | 可信度 |
+|---|---|---|---|
+| _(待填)_ | | | |
+
+### C. 课程内容与方法论
+| 主题 | 页面 | 更新时间 | 可信度 |
+|---|---|---|---|
+| _(待填)_ | | | |
+
+### D. 交付与运营
+| 主题 | 页面 | 更新时间 | 可信度 |
+|---|---|---|---|
+| _(待填)_ | | | |
+
+---
+
+## 目录地图
+
+```
+00-原材料/        ← 唯一输入区,只进不改(人要改就换新文件)
+  _inbox/         ← 随手丢这里,同步时自动分流
+  01-行业资料/    ← 行业报告、白皮书、政策文件
+  02-客户与需求/  ← 客户沟通记录、需求表、招标文件
+  03-课程素材/    ← 案例、练习、讲义草稿、参考课件
+  04-竞品与参考/  ← 同行课程大纲、公开课录像笔记
+
+10-知识库/        ← 全 md,LLM 维护,人可读
+  index.md        ← 本文件:业务路由
+  _meta/          ← 机器状态(manifest / 关系图 / 日志),一般不用看
+  _archive/       ← 因源删除而归档的页面,可回溯
+  sources/        ← 一源一页
+  topics/         ← 多源合成的主题结论
+  entities/       ← 人/机构/工具/政策/术语
+  modules/        ← 可进课表的课程模块
+
+20-课程产出/      ← 最终交付物(大纲、讲义、PPT、讲师手册),按课程分目录
+
+30-技能/          ← 做课与管库的 skill
+90-工具/          ← kb.py 及辅助脚本
+```
+
+---
+
+## 最近同步
+
+| 时间 | 操作 | 摘要 |
+|---|---|---|
+| _(首次同步后自动登记)_ | | |
+
+> 完整流水在 `_meta/CHANGELOG.md`(人读)与 `_meta/changelog.jsonl`(机器读)。

+ 6 - 0
10-知识库/modules/_index.md

@@ -0,0 +1,6 @@
+# 课程模块索引
+
+> 自动生成于 2026-11-04T18:30:38+08:00,共 0 条。请勿手改,改页面 frontmatter 后重跑 `kb.py graph`。
+
+_(暂无内容)_
+

+ 6 - 0
10-知识库/sources/_index.md

@@ -0,0 +1,6 @@
+# 来源页索引
+
+> 自动生成于 2026-11-04T18:30:38+08:00,共 0 条。请勿手改,改页面 frontmatter 后重跑 `kb.py graph`。
+
+_(暂无内容)_
+

+ 6 - 0
10-知识库/topics/_index.md

@@ -0,0 +1,6 @@
+# 主题页索引
+
+> 自动生成于 2026-11-04T18:30:38+08:00,共 0 条。请勿手改,改页面 frontmatter 后重跑 `kb.py graph`。
+
+_(暂无内容)_
+

+ 42 - 0
30-技能/_index.md

@@ -0,0 +1,42 @@
+# 技能索引
+
+> 技能是"方法",不是"代码"。每个技能是一份可执行的作业指导书。
+> 客观事实交给 `90-工具/kb.py`,语义判断交给技能。
+
+## 管库(kb-*)
+
+| 技能 | 何时用 | 核心产出 |
+|---|---|---|
+| [`course-factory`](course-factory/SKILL.md) | 任何与本库相关的操作,先过它 | 诊断 + 分流 |
+| [`kb-sync`](kb-sync/SKILL.md) | 有新增/变更/删除/移动 | 差异处理完毕 |
+| [`kb-ingest`](kb-ingest/SKILL.md) | 单个文件怎么拆页、怎么命名 | 原子化页面 |
+| [`kb-query`](kb-query/SKILL.md) | 查东西 | 带出处的答案 |
+| [`kb-lint`](kb-lint/SKILL.md) | 体检、修腐化 | 健康报告 + 修复 |
+| [`kb-index`](kb-index/SKILL.md) | 索引不对、要合并/拆页 | 索引正确 |
+
+## 做课(course-*)
+
+| 技能 | 何时用 | 核心产出 |
+|---|---|---|
+| [`course-outline`](course-outline/SKILL.md) | 从零做一门课 | 需求确认 + 大纲 + 模块详案 + 缺口 |
+| [`course-slides`](course-slides/SKILL.md) | 大纲要变课件 | 讲师版 PPT + 备注 |
+
+## 调用关系
+
+```
+course-factory  ←  所有请求从这里进
+    ├─ 要看库  → kb-query
+    ├─ 要更新  → kb-sync ──(单个文件)──▶ kb-ingest
+    ├─ 要维护  → kb-lint / kb-index
+    └─ 要做课  → course-outline ──▶ course-slides
+```
+
+## 加一个新技能
+
+1. 在 `30-技能/` 下建目录 `xxx/`,写 `SKILL.md`(frontmatter 必须有 `name` 和 `description`,description 里带触发词)
+2. 在 `90-工具/register_skills.py` 的 `SKILLS` 列表里加名字
+3. 跑 `python 90-工具/register_skills.py`
+4. 在 `course-factory/SKILL.md` 的分流表里加一行
+5. 在上面的表格里加一行
+
+**判断一个技能该不该建**:如果它做的事能用一段话讲清且不需要重复讲,就写进 `course-factory` 而不是建技能。技能是给"会反复执行、且有固定招式"的流程用的。

+ 138 - 0
30-技能/course-factory/SKILL.md

@@ -0,0 +1,138 @@
+---
+name: course-factory
+tags: [education, course-development, knowledge-base, llm-wiki, repo-management]
+creator: 传鹏
+description: |-
+  做课系统总入口。以 llm-wiki 思路管理的课程开发知识库:原材料单向进入 → LLM 整理成结构化 md 知识库 → 从库里取材生成课程。负责整体激活、状态诊断、意图分流与库维护编排。
+
+  触发词:做课系统、知识库、同步资料、增量入库、整理资料、做课、开发课程、课程大纲、讲义、检查知识库、库健康、课程工厂、知识库维护、回滚知识库
+---
+
+# 做课系统 · 总入口
+
+## 这个系统是什么
+
+一条单向管道:**原材料(只进不改)→ 知识库(全 md,LLM 维护)→ 课程产出**。
+
+```
+00-原材料/  ──整理──▶  10-知识库/  ──取材──▶  20-课程产出/
+ (is input)            (is memory)           (is output)
+    ↑                      ↑                      ↑
+    └────── 90-工具/kb.py 管结构,30-技能/* 管语义 ──────┘
+```
+
+**分工铁律**(违反必出错):
+
+| 谁 | 管什么 | 不管什么 |
+|---|---|---|
+| `kb.py` | 文件指纹、差异计算、关系图、索引重建、回滚 | 任何内容语义 |
+| 你(LLM) | 读源、抽取、归纳、写页、写摘要 | 任何需要"记住"的状态 |
+
+**永远不要让 LLM 用记忆去判断"哪些文件新增了"** —— 跑 `kb.py scan`。这是这套系统和裸聊天的唯一区别。
+
+---
+
+## 两种模式,规则相反
+
+进这个库的请求只有两类,**判断错了后面全错**:
+
+| | 补料(往库里加) | 取材(从库里拿) |
+|---|---|---|
+| 典型说法 | 丢了资料、同步、整理、删了源 | 做一门课、查一下、出大纲、要课件 |
+| 能不能补充原文件没有的 | **不能** | **能**(组合、提炼、编排) |
+| 出处要求 | 指回原文件具体段落 | 每个数字标 `[^脚注]` 或 `[[页面]]` |
+| 缺东西时 | 标「待核实」,不许猜 | 明说「库里没有」,不许编 |
+| 证据等级 | 按原文件性质如实定 | 不得高于所用素材最低级 |
+| 写完必须 | `kb.py mark` 登记 | 在 `03-缺口与补料.md` 记缺口 |
+
+**补料在给库里攒信用,取材在花信用。** 补料时随手编一句,三个月后做课就会把它当事实讲给客户。
+
+---
+
+## 第 0 步:定位仓库(每次激活必做)
+
+```bash
+python 90-工具/kb.py status
+```
+
+- 若报 `No such file`,说明 cwd 不在仓库根。按顺序探测:① 当前目录含 `90-工具/kb.py`;② 默认路径 `C:\Users\15858\WorkBuddy\2026-11-04-18-25-54\做课系统`。
+- 输出会告诉你:原料数、页面数、待处理新增/删除、待重建、陈旧页。
+- **`status` 是唯一可信的库状态来源。不要凭对话历史推断库里有几篇文档。**
+
+---
+
+## 第 1 步:意图分流
+
+| 用户说 | 走哪个技能 | 判据 |
+|---|---|---|
+| "同步""整理新资料""我丢了几个文件" | `kb-sync` | 有 pending new/changed |
+| "删了源文件怎么办""清理" | `kb-sync` 的 retract 分支 | 有 pending gone |
+| "查 XX""库里有没有 XX""关于 XX 的资料" | `kb-query` | 只想读 |
+| "做一门课""出大纲""要讲义""要 PPT" | `course-outline` → `course-slides` | 要产出 |
+| "检查库""有没有问题""整理得乱不乱" | `kb-lint` | 维护 |
+| "索引不对""找不到页面" | `kb-index` | 索引重建 |
+| 只是问"这系统怎么用" | 直接答,别跑脚本 | — |
+
+**分流不确定时,先跑 `status`**,库的状态会告诉你用户大概率想干什么:
+- 有 10 个未入库文件 → 大概想说"同步"
+- 有 3 个 stale → 大概想说"检查/修复"
+- 库是干净的空库 → 大概想"建库/丢资料"
+
+---
+
+## 第 2 步:维护编排
+
+### 日常同步(最高频)
+```
+status → scan → 逐个 ingest → graph → lint → 汇报
+```
+详见 `kb-sync`。
+
+### 每周健康检查
+```
+kb.py check → 按问题类型分派修复 → graph
+```
+
+`kb.py check` 一次跑两件事:
+- `kb.py lint` 管**结构**(死链、孤儿、缺字段、证据等级虚高)
+- `check-content.py` 管**内容**(AI 腔、长句、没出处的数字)
+
+结构对了不等于能拿去做课。两边都要过。
+
+### 每月沉淀
+- 看 `_meta/changelog.jsonl`,找出长期没人访问的 topic 页 → 考虑合并或归档
+- 看 `topics/_index.md`,检查是否有"同一件事拆成多页" → 合并
+
+---
+
+## 全局规则
+
+1. **先证后写** — 写进知识库的每个事实必须能追到某个源文件的某一段。追不到的标「(推测)」。
+2. **只增不改原材料** — 任何人不得修改 `00-原材料/` 里已入库的文件。要改就放新版本进去,让 `kb-sync` 识别为 NEW,旧版由用户手动清理。
+3. **写完必登记** — 每整理完一个源,必须 `kb.py mark <路径> --pages <页面列表>`,否则下次还当它是新的,白干一遍。
+4. **删了必回滚** — 源文件消失必须跑 `kb.py retract`,否则知识库里留下"引用不存在的源"的僵尸页。
+5. **索引不手写** — `_index.md` 一律由 `kb.py graph` 生成。要改就改页面 frontmatter。
+6. **做课先查库** — 用户说"做一门课"时,禁止直接凭模型知识写大纲。必须先 `kb-query` 取材,并在产出里标出每个模块的素材出处。库里没有的,明说"库里缺 X,建议补料",而不是编一个。
+7. **每页必标证据等级** — `evidence: A/B/C/D`,木桶规则(不得高于来源最低级)。**做课的讲授内容里 A+B 不低于 60%,D 级一律不上课件。** 这是"课经不经得起追问"的唯一量化保证。
+8. **说"某机构测算",不说"数据显示"** — B 级内容当 A 级讲,是这门生意最容易翻车的地方。学员或客户里总有一个人会问"这个数据哪来的"。
+9. **提交前跑 `kb.py check`** — 结构 + 内容两项都过再交付。结构干净但满是"值得注意的是"的知识库,做出来的课一样没人看。
+
+---
+
+## 汇报格式
+
+每次操作结束,用这个格式回给用户(不要贴原始 JSON):
+
+```
+这次同步
+  新增   3 个源 → 派生了 7 个页面
+  变更   1 个源 → 重建 2 个页面
+  删除   0
+  待重建 0
+  健康分 92/100
+
+库里现在:42 页(源 18 / 主题 15 / 实体 6 / 模块 3)
+下一步建议:topics/客户画像 还是空的,要不要补一份客户访谈记录?
+```
+
+末尾给一个**具体的下一步建议**,不要空泛地说"还需要什么随时告诉我"。

+ 207 - 0
30-技能/course-outline/SKILL.md

@@ -0,0 +1,207 @@
+---
+name: course-outline
+tags: [course-design, curriculum, instructional-design]
+creator: 传鹏
+description: |-
+  从知识库取材生成课程大纲与模块详案。先澄清需求,再检索库内素材,按"讲授:练习:复盘"配比排出模块与时长,每个模块标注素材出处,最后输出缺口清单。
+
+  触发词:做一门课、开发课程、出大纲、课程设计、内训方案、课程框架、排课表、模块设计
+---
+
+# 做课:从库到可交付大纲
+
+## 第 0 步 · 需求澄清(**不许跳过**)
+
+以下 5 项缺任何一项,先问清楚再动手:
+
+| 项 | 为什么必须知道 |
+|---|---|
+| **学员是谁** | 岗位、职级、AI 使用经验。决定讲多深 |
+| **要解决什么业务问题** | "学 AI"不是需求,"客服响应慢 30%" 才是 |
+| **时长与形式** | 半天/1天/3天2晚,线上/线下,是否有晚课 |
+| **交付物** | 只要讲授?要产出 PPT 模板?要每组交一个作品?要认证? |
+| **验收标准** | 老板/客户怎么判断课讲成功了 |
+
+如果用户说"你看着办",按公司主力产品默认值走并在方案开头声明假设:
+> 假设:3天2晚 / 40人 / 零基础到能用 / 交付物是每组一个可跑的 Agent 工作流。如不符请指出。
+
+---
+
+## 第 1 步 · 取材(**禁止凭记忆写大纲**)
+
+对每个候选模块主题,走 `kb-query`:
+
+```bash
+python 90-工具/kb.py status        # 先确认没有未整理的料
+```
+
+然后按主题检索 `topics/`、`modules/`、`sources/`。
+
+**产出物是一张素材对照表**,不是大纲:
+
+| 模块主题 | 库内素材 | 页路径 | 证据等级 | 判定 |
+|---|---|---|---|---|
+| 提示词工程 | 三类基础方法 + 5 个行业案例 | `modules/D1-提示词工程.md` | B | 可做,讲时说「案例来自…」 |
+| Agent 编排 | 仅 1 份工具文档 | `sources/Coze文档.md` | C | 可做,但必须标「经验为主」 |
+| 企业落地路径 | 无 | — | — | 缺,不许硬编 |
+| 市场规模 | 白皮书测算 380 亿 | `topics/AI培训市场.md` | B | 可做,说「某机构测算」 |
+
+**证据等级决定这个模块能讲多重的话**:
+
+| 等级 | 课里怎么说 |
+|---|---|
+| A | 直接讲,页脚标出处 |
+| B | 必须说「某机构测算」「有研究显示」,不能说「数据显示」 |
+| C | 必须说「我们的经验是」,不能当结论,不能写进 PPT 标题 |
+| D | **不上课件**。只能作为「待验证假设」放进讲师备注 |
+
+「缺」的模块不要硬编。要么换成库里有料的方向,要么明确告诉用户"这块需要补料才能讲"。
+
+---
+
+## 第 2 步 · 排结构
+
+### 时间预算(AI 技能类课程的硬约束)
+
+| 总时长 | 有效教学时间 | 讲授 | 动手 | 复盘/答疑 |
+|---|---|---|---|---|
+| 半天 | 3.5h | 1.2h | 1.8h | 0.5h |
+| 1 天 | 6.5h | 2.2h | 3.5h | 0.8h |
+| 2 天 | 13h | 4.5h | 7h | 1.5h |
+| 3 天 2 晚 | 19h | 6.5h | 10.5h | 2h |
+
+**讲授占比不超过 35%** —— 这是 AI 技能课和传统讲授式培训的分水岭。超过这个比例,学员回去什么都不会。
+
+### 模块切法
+
+每个模块必须能回答"学完这个,学员手上多了一个什么东西"。
+
+```
+模块 ≠ 知识点罗列
+模块 = 一个完整的能力闭环(输入 → 处理 → 输出 → 检验)
+```
+
+好模块:「能用 15 分钟把一个模糊需求变成可执行的提示词模板,并当场跑通」
+坏模块:「提示词的定义、分类、发展历史、注意事项」(这是教材,不是训练)
+
+### 递进结构(3 天 2 晚参考)
+
+```
+D1 上午  认知对齐 + 第一个可用产出(必须让学员当天有成就感)
+D1 下午  核心方法 + 高频场景覆盖
+D1 晚    工作坊:把自己的真实工作流拆解一遍
+D2 上午  从单点到流程(编排/自动化)
+D2 下午  组队做真实业务课题
+D2 晚    辅导打磨
+D3 上午  成果发布 + 互评
+D3 下午  落地机制(谁负责、怎么考核、怎么复用)+ 结课
+```
+
+---
+
+## 第 3 步 · 写大纲
+
+输出到 `20-课程产出/<客户简称>-<课程名>-<YYYYMM>/`:
+
+```
+00-需求确认.md      ← 第 0 步的澄清结果 + 假设声明
+01-课程大纲.md      ← 一页纸能看完全貌
+02-模块详案/        ← 每个模块一个 md
+03-缺口与补料.md    ← 库内素材不够的地方
+04-交付物清单.md    ← 学员产出什么、讲师交付什么
+```
+
+### `01-课程大纲.md` 骨架
+
+```md
+# <课程名>
+
+> 学员:__ / 时长:__ / 人数:__ / 形式:__
+> 一句话目标:学完能 ___
+
+## 能力地图
+(学完前后对比,3–5 条)
+
+## 课表
+
+| 时间 | 模块 | 形式 | 产出 | 素材出处 |
+|---|---|---|---|---|
+| D1 09:00–10:30 | M1 认知对齐 | 讲授+投票 | 个人 AI 使用现状清单 | `topics/企业AI落体现状.md` |
+| ... | | | | |
+
+## 设计说明
+(为什么这么排:难度曲线、练习节奏、为什么先讲这个后讲那个)
+```
+
+**「素材出处」列不许留空。** 留空说明这个模块是编的。
+
+### `02-模块详案/<Mx-模块名>.md` 骨架
+
+```md
+# M2 提示词工程
+
+**时长** 120 分钟(讲授 40 / 练习 70 / 复盘 10)
+**学员产出** 一份自己岗位的提示词模板库(≥3 条)
+
+## 学习目标
+- 能说出好提示词的 4 个要素
+- 能把自己岗位的一个高频任务改写成模板
+
+## 内容线
+1. 为什么同一句话,AI 给出的结果差十倍(10min,对比演示)
+2. 四要素:角色 / 任务 / 约束 / 示例(25min)
+3. 现场改写(60min,用学员自己的真实任务)
+4. 互评 + 讲师点评(15min)
+
+## 使用素材
+- 三类基础方法 → `sources/提示词案例集.md`
+- 行业案例 → `modules/D1-提示词工程.md` 第 3 节
+
+## 常见卡点
+- 学员会写成"帮我写个方案" → 现场用这个反例演示
+- 有人觉得"这不就是聊天" → 用前后对比数据打掉
+
+## 讲师提示
+(语气、节奏、什么时候该停下来等)
+```
+
+---
+
+## 第 3.5 步 · 证据配比自检(决定这门课的性质)
+
+数一下讲授内容的等级分布,写在大纲开头:
+
+```
+证据配比:A 20% / B 45% / C 35% / D 0%
+```
+
+- **A+B ≥ 60%** → 这是一门"有依据的课",可以对外报价
+- **A+B 在 40–60%** → 能讲,但销售时必须说清"部分内容是我们的实践总结"
+- **A+B < 40%** → 这门课本质是讲师经验分享。**要么补料,要么改定位**,不要包装成有数据支撑的课
+
+这不是学术洁癖。客户里总有一个人会问"这个 42% 哪来的",答不上来,后面所有内容都会被怀疑。
+
+---
+
+## 第 4 步 · 缺口报告(这是课程质量的诚实度)
+
+`03-缺口与补料.md`:
+
+```md
+# 素材缺口
+
+| 模块 | 缺什么 | 影响 | 补料建议 |
+|---|---|---|---|
+| M5 Agent 编排 | 缺 2 个真实企业落地案例 | 学员会觉得虚 | 补 `02-客户与需求/` 里的实施记录,或访谈 1 家已落地的客户 |
+| M7 效果评估 | 无任何库内素材 | 该模块目前靠讲师经验 | 补 1 份 ROI 测算方法论 |
+```
+
+**不许把缺口藏起来。** 一个诚实标了 3 个缺口的方案,比一个看起来完美但经不起追问的方案有价值得多。
+
+---
+
+## 交付后
+
+课程跑完,把现场产生的东西(学员作品、提问、卡点、讲师复盘)放回 `00-原材料/03-课程素材/<课程名>-复盘/`,然后 `kb-sync`。
+
+**这是这套系统的复利来源**:下次做同类课,库里的素材比这次厚一倍。

+ 112 - 0
30-技能/course-slides/SKILL.md

@@ -0,0 +1,112 @@
+---
+name: course-slides
+tags: [course-design, ppt, teaching-materials]
+creator: 传鹏
+description: |-
+  把课程大纲/模块详案转成授课用 PPT。控制每页信息密度,按"一页一个观点"排版,生成讲师备注,标注素材出处。
+
+  触发词:做课件、生成PPT、课程PPT、讲义转PPT、上课用的幻灯片、讲师版PPT
+---
+
+# 大纲 → 授课 PPT
+
+## 前置条件
+
+必须有 `20-课程产出/<课程>/01-课程大纲.md` 和 `02-模块详案/`。
+没有就先跑 `course-outline`。**不要跳过设计直接生成 PPT** —— 那样出来的是一堆好看的废话。
+
+---
+
+## 一页只讲一件事(唯一硬规则)
+
+| 页面类型 | 内容上限 |
+|---|---|
+| 章节过渡页 | 一句话 + 一个数字 |
+| 概念页 | 1 个论点 + 3 条支撑 |
+| 案例页 | 1 个场景 + 1 组数据 + 1 个结论 |
+| 练习页 | 1 个任务 + 交付要求 + 时间 |
+| 金句页 | 一句金句 + 出处 |
+
+**正文超过 60 字就是讲义,不是幻灯片。** 讲师要说的话全部放备注,不放页面。
+
+---
+
+## 结构模板(按 90 分钟单元)
+
+```
+1  封面            课程名 / 讲师 / 期次
+2  本单元议程      3–4 条,让学员知道要去哪
+3  痛点钩子        一个学员有体感的场景(不要讲定义)
+4  核心概念        1 页一个
+5  正例            做了会怎样
+6  反例            不做会怎样(对比比单讲有效 3 倍)
+7  方法/步骤       3–5 步,可用流程图
+8  现场演示        截图或录屏封面
+9  练习任务        明确交付物和时限
+10 互评标准        3 条,越短越好
+11 小结            回扣第 3 页的痛点
+```
+
+一个 90 分钟单元 10–14 页。**3 天课程 120–160 页是正常量。**
+
+---
+
+## 生成方式
+
+优先用现成的 PPT 技能,不要手搓:
+
+| 场景 | 用哪个 |
+|---|---|
+| 从零生成完整 pptx | `workbuddy-pptx` |
+| 要统一的视觉模板 | `ppt-template-design`(布衣公子方法论) |
+| 科技感/赛博朋克风格 | `shencp-ppt-design` |
+| 单文件 HTML 横版 PPT | `guizang-ppt-skill` |
+
+**先定风格再批量生成**:先生成 3 页(封面 + 内容页 + 练习页)给用户确认风格和密度,确认后再铺满全篇。铺完再改风格是最贵的返工。
+
+---
+
+## 讲师备注(决定这份 PPT 能不能直接用)
+
+每页备注必须写:
+
+```md
+【讲什么】这一页的核心一句话
+【怎么讲】用什么类比/故事/提问切入,预计几分钟
+【素材】出自 sources/xxx.md 第 N 节
+【注意】常见误解 / 敏感点 / 可跳过的部分
+```
+
+没有备注的 PPT = 只有讲师本人能讲。有了备注,任何合格讲师都能接手。
+
+---
+
+## 素材引用规则
+
+- PPT 上的数据必须能追到 `sources/`
+- **D 级内容一律不上课件**(见 `_meta/约定.md` 第三节)。要讲也只能放讲师备注里的「待验证」
+- **C 级内容不许写进页面标题**,只能出现在正文并配「我们的经验是」这类限定语。学员会记住标题,不会记住限定语
+- 引用外部数据时在页脚标来源(增强可信度,也是合规要求)
+- 客户名称、内部数据上 PPT 前确认是否脱敏
+- **库里的案例可以直接用;库里没有的现编案例不要上 PPT** —— 学员一追问就穿帮
+
+---
+
+## 输出
+
+```
+20-课程产出/<客户>-<课程名>-<YYYYMM>/
+  05-课件/
+    <课程名>-讲师版.pptx
+    <课程名>-学员版.pdf      (去掉备注和答案)
+  05-课件/备注汇编.md        (所有页面备注的文本版,便于讲师预习)
+```
+
+交付前检查:
+- [ ] 每页正文 ≤ 60 字
+- [ ] 每页都有备注
+- [ ] 练习页都写清了交付物和时限
+- [ ] 所有数据都有出处
+- [ ] **没有 D 级内容,C 级内容没进标题**
+- [ ] 客户敏感信息已处理
+- [ ] 学员版不含答案和讲师话术

+ 127 - 0
30-技能/kb-index/SKILL.md

@@ -0,0 +1,127 @@
+---
+name: kb-index
+tags: [knowledge-base, indexing, navigation, routing]
+creator: 传鹏
+description: |-
+  知识库索引与导航维护。维护三层索引体系(业务地图 → 目录索引 → 页面摘要),处理页面合并/拆分后的索引修复、别名补充、业务地图重组。
+
+  触发词:索引、找不到页面、知识库导航、重建索引、业务地图、合并页面、拆分页面、别名
+---
+
+# 索引维护
+
+## 三层索引,各司其职
+
+| 层 | 文件 | 谁写 | 回答什么问题 |
+|---|---|---|---|
+| L1 业务地图 | `10-知识库/index.md` | **人 + LLM** | "我该从哪个方向找" |
+| L2 目录索引 | `*/_index.md` | **`kb.py graph` 自动生成** | "这个方向下有哪些页" |
+| L3 页面摘要 | 每页 frontmatter 的 `summary` | **写页时顺手写** | "这页具体讲什么" |
+
+**关键认知**:L2 已经是自动的,所以索引腐化的真正来源只有两处 ——
+① L1 业务地图没人维护;② L3 的 `summary` 写得敷衍(写成"本文介绍了 XX")。
+
+---
+
+## L1 业务地图怎么维护
+
+`index.md` 的业务地图**按业务问题分区,不按文件类型分区**。
+
+当前四个分区对应本公司的做课业务链:
+- **A 市场与行业认知** —— 判断"卖什么课给谁"
+- **B 客户与需求画像** —— 判断"这门课要解决什么问题"
+- **C 课程内容与方法论** —— 课里装什么
+- **D 交付与运营** —— 怎么落地、怎么复购
+
+### 什么时候动它
+
+| 触发 | 动作 |
+|---|---|
+| 新建了一个 topic 页 | 在对应分区挂一行 |
+| 某个 topic 页被归档 | 删掉那一行 |
+| 分区长期为空(>1 个月) | 要么它是真需求(去补料),要么删掉这个分区 |
+| 出现新的业务线 | 加分区 |
+| 用户说"我找不到 XX" | 说明地图的组织方式和用户的思维方式不一致 → 调整分区命名,别让用户适应系统 |
+
+### 行怎么写
+
+```md
+| 客户决策链 | [topics/客户决策链.md](topics/客户决策链.md) | 2026-11-04 | 中(2 源) |
+```
+
+「可信度」列用源的数量和时效粗判:1 源 = 低,2–3 源 = 中,≥4 源且最近更新 = 高。
+
+---
+
+## 别名:解决"用户说的话和页面标题不一样"
+
+在页面 frontmatter 加:
+
+```yaml
+aliases:
+  - "企业内训"
+  - "B端培训"
+  - "公司培训"
+```
+
+`kb-query` 的 Level 2 会检索 aliases。**没有任何技术门槛,但这是检索命中率提升最明显的一招。**
+
+给哪些页加:
+- 客户/机构(全称、简称、英文名、项目代号)
+- 方法论(正式名、俗称)
+- 术语(中英文对照)
+
+---
+
+## 合并页面(拆多了的情况)
+
+症状:两个页面的 `summary` 几乎一样,或者互相大量交叉引用。
+
+步骤:
+1. 选主体页(更新更频繁、入链更多的那个)
+2. 把另一页的有效内容搬过去,**保留所有 `[^脚注]` 溯源**
+3. 合并 `sources` 两个列表(去重)
+4. 合并 `tags`、`related`
+5. 被吞并的页 → 文件内容改成一行 `已合并至 [[主体页]]`,或者直接移入 `_archive/`
+6. 全库替换 `[[被吞并页]]` → `[[主体页]]`
+7. `kb.py graph` + `lint`
+
+---
+
+## 拆分页面(装太满的情况)
+
+症状:一个 topic 页超过 1500 字,且明显有 2 个以上独立主题。
+
+不要急着拆。先问:**读者会不会只想看其中一部分?** 会才拆。
+
+拆完必须:
+- 两个新页都要保留原 `sources` 中相关的部分
+- 建一个 index 型页或让 `index.md` 业务地图同时指向两页
+- 检查所有指向原页的反链,分派到两个新页
+
+---
+
+## 反链的价值
+
+`[[X]]` 的指向关系会被 `kb.py graph` 解析成 `_meta/derivations.jsonl` 里的 `links` 边。
+
+这个图有两个用途:
+1. `kb-lint` 找孤儿页(零入链)
+2. `kb.py retract` 做级联失效(删一页,找出所有依赖它的页)
+
+**所以:正文里该链的地方不链,等于放弃了自动保鲜能力。** 一个页面如果被删了但没人链它,系统就不知道哪些内容受影响。
+
+---
+
+## 索引重建
+
+任何时候索引看起来不对:
+
+```bash
+python 90-工具/kb.py graph
+```
+
+它做两件事:重建 `derivations.jsonl`(全部关系边)+ 重写四个 `_index.md`。
+**不会动 `index.md` 和任何页面内容。**
+
+如果你改了 `index.md` 的业务地图但发现行链接指向不存在的页面 → 那是页面被删了,跑 `lint` 找 `DEAD_LINK`。

+ 112 - 0
30-技能/kb-ingest/SKILL.md

@@ -0,0 +1,112 @@
+---
+name: kb-ingest
+tags: [knowledge-base, atomic-notes, content-extraction]
+creator: 传鹏
+description: |-
+  单源精读与原子化方法。决定一个原材料应该拆成几个知识页、每页装什么、怎么命名,保证知识库颗粒度一致。kb-sync 调用它处理单个文件,也可单独用于"把这个文件整理进库"。
+
+  触发词:整理这个文件、精读、拆解资料、这个文档入库、原子化、把资料整理成笔记
+---
+
+# 单源精读与原子化
+
+## 核心问题:一个文件该拆几页?
+
+**判据:读者会不会"只想看其中一部分"。**
+
+| 情形 | 拆几页 |
+|---|---|
+| 一份 60 页行业报告,含市场规模、竞争格局、技术趋势三大块 | 1 个 source 页 + 3 个 topic 页 |
+| 一份客户需求表,只有时长/人数/要点 | 1 个 source 页(可能顺手并进已有客户 topic) |
+| 一份 200 页 PPT 课件 | 1 个 source 页 + N 个 module 页(每个可上课的单元一页) |
+| 一份纯广告宣传册 | 1 个 source 页,不派生 |
+| 三段微信聊天记录截图 | 1 个 source 页(内容是碎片,别装进多个页) |
+
+**反例**:把一份报告拆成 20 个"知识点"页,每页 80 字 —— 这叫碎片化,不叫原子化。查的时候要在 20 个页之间跳,还不如读原报告。
+
+**原子化的正确含义**:一页 = 一个完整的、能独立回答一个问题的知识单元。不是"一句话一页"。
+
+---
+
+## 颗粒度自检(写完每页问自己)
+
+1. 这页的标题能不能填进「关于 ___ 我该知道什么」的空里?填不进去 → 颗粒度不对
+2. 这页能不能被单独发给一个同事,他看完不需要问"上下文是什么"?
+3. 这页如果被删掉,会有别的页受影响吗?会 → 它是被依赖的核心页,值得存在;不会,且也没人引用 → 它可能不该单独存在
+
+---
+
+## 命名规则
+
+| 类型 | 规则 | 好例子 | 坏例子 |
+|---|---|---|---|
+| source | **沿用原材料文件名**(去扩展名) | `2026-AI培训行业白皮书.md` | `资料1.md`、`白皮书摘要.md` |
+| topic | **业务问题的名词短语**,不带"研究""分析""总结" | `企业AI培训市场规模.md`、`客户决策链.md` | `市场分析.md`、`关于客户的一些思考.md` |
+| entity | **专有名词本名** | `某国有大行.md`、`Coze.md`、`生成式AI服务管理暂行办法.md` | `银行客户.md`、`某工具.md` |
+| module | **`D<序号>-<模块名>`**,与课表一致 | `D1-提示词工程.md`、`D2-Agent编排.md` | `第一模块.md`、`提示词.md` |
+
+- 文件名即页面 stem,`[[链接]]` 用它。
+- **不含空格**,用中划线或直接连写。含空格会让双链和命令行都变难用。
+- 一旦有页面引用它,**不要改名**(会让所有反链断裂)。必须改就走「改名四步」:改文件 → 全库 grep 老 stem → 批量替换 → `kb.py graph` + `lint` 验证。
+
+---
+
+## 抽取什么、不抽取什么
+
+### 抽(有长期价值)
+- 具体数字(规模、增速、单价、人数、时长)
+- 可复用的方法/框架/步骤
+- 客户原话(做课时的真实语料,比转述值钱十倍)
+- 反常识的结论
+- 明确的约束条件("仅适用于 50 人以下")
+
+### 不抽
+- 客套话、免责声明、目录页
+- 已经被同页其他内容覆盖的重复表述
+- 只有结论没有论据的断言(除非标注来源权威)
+- 时效性极强的琐碎信息(某天的股价)
+
+---
+
+## 特别处理:客户沟通类资料
+
+聊天记录、会议纪要、需求表——这类料的价值**不在结论,在细节和原话**。
+
+- 一定要抽「客户原话」区,照抄不改写
+- 一定要抽「隐含需求」:客户说的和真正要的往往不是一回事("要讲 AI" 可能是"要给领导交差")
+- 单独建/更新 `entity` 页记录这个客户:行业、规模、决策人角色、历史合作、禁忌话题
+
+---
+
+## 定证据等级(每页必做,30 秒)
+
+写完内容回头看一眼:**这页里最强的那条信息,站得住吗?** 站不住就按最弱的定。
+
+| 问自己 | 是 → 定 |
+|---|---|
+| 数字有一手出处、口径明确、能当场调出原文核对吗? | **A** |
+| 有报告/研究支撑,但样本小、口径不明、或者只有一家在做吗? | **B** |
+| 只是从业者经验、行业共识,说不出具体来源吗? | **C** |
+| 是我的推断、假设,还没人验证过吗? | **D** |
+
+两个容易搞错的地方:
+
+- **客户口头说的数字是 C,不是 A。** 客户说"我们现在 AI 使用率大概 30%",没有书面数据支撑,就是 C。除非他给了台账。
+- **行业报告里的行业数据是 B,不是 A。** 咨询公司白皮书自己都标"测算"。只有国家统计局、上市公司财报这类才是 A。
+
+`topic` 和 `module` 页的等级**不得高于**它所用素材的最低级。合成不会提高证据强度,只会稀释。
+
+---
+
+## 写完的验收清单
+
+- [ ] frontmatter 七个必填字段齐全(id/type/title/summary/**evidence**/tags/sources)
+- [ ] `evidence` 按上面那三问定的,不是顺手写的
+- [ ] `sources:` 填的是原材料相对路径,一字不差
+- [ ] 正文 ≥ 100 字,且前 3 行内有结论
+- [ ] 有具体信息的都带了 `[^脚注]` 或明确出处
+- [ ] **带 万/亿/%/倍/元 的数字,同段落里有出处**
+- [ ] 推测的内容标了「(推测)」
+- [ ] 没有"值得注意的是""本页介绍""综上所述"这类话
+- [ ] 相关页面用 `[[stem]]` 链上了
+- [ ] `kb.py mark` 已登记(否则等于没做)

+ 114 - 0
30-技能/kb-lint/SKILL.md

@@ -0,0 +1,114 @@
+---
+name: kb-lint
+tags: [knowledge-base, quality, maintenance, health-check]
+creator: 传鹏
+description: |-
+  知识库健康检查与修复。检测死链、孤儿页、陈旧页、源漂移、索引漂移、空壳页,按严重度分派修复,输出健康分与维护建议。
+
+  触发词:检查知识库、库健康、整理得乱不乱、有没有死链、知识库体检、修复知识库、lint
+---
+
+# 知识库体检
+
+## 跑起来
+
+```bash
+python 90-工具/kb.py check        # 结构 + 内容,两项一起过(推荐)
+python 90-工具/kb.py lint --json  # 只查结构,机器可读
+python 90-工具/check-content.py   # 只查内容(AI 腔 / 长句 / 没出处的数字)
+```
+
+`lint` 返回 `summary`(页数/源数/问题数/健康分/待重建数)+ `issues`(每条带 `kind`、`page`、`detail`)。
+`check-content.py` 是另一个文件,因为**结构对了不等于内容能用**,两者职责不同,混在一起以后没人敢改。
+
+**健康分算法**:`100 - 问题数×3 - 待重建数×2`,最低 0。
+- ≥ 90 绿:健康
+- 70–89 黄:能用,但有腐化
+- < 70 红:结构性问题,停下来修
+
+---
+
+## 问题类型与修法
+
+按**根因 → 表象**的顺序修。先修下面的,上面的会自动消失。
+
+### 第一梯队(根因,必须先修)
+
+| kind | 含义 | 修法 |
+|---|---|---|
+| `DANGLING_SOURCE` | 页面引用的源已不在 manifest | 分两种:① 源是被误删的 → 恢复文件后 `kb.py scan` + `mark`;② 源确实作废了 → `kb.py retract` 走正规回滚。**不要直接手改 frontmatter 删掉那条 sources**,那样 `sources` 与事实脱节,下次同步还会错 |
+| `SOURCE_DRIFT` | 源文件内容变了,页面没更新 | 走 `kb-sync` 的 CHANGED 分支 |
+| `STALE` | 页面被标记待重建 | 读完 `stale_reason` 再动手:源还在就重合成,源没了就降级为 draft 并在正文注明依据缺失 |
+
+### 证据类(最容易被糊弄过去的一组)
+
+| kind | 含义 | 修法 |
+|---|---|---|
+| `MISSING_EVIDENCE` | 页面没标 `evidence` | 按 `kb-ingest` 的「定证据等级」三问补上。拿不准就往低了定 |
+| `BAD_EVIDENCE` | 等级写成了 A/B/C/D 以外的东西 | 改成单字母 |
+| `EVIDENCE_INFLATED` | 声明的等级比它来源最低级还强 | **降级,不要改来源。** 合成不会提高证据强度。如果确实有更强的来源,先把那个源补进来 |
+| `D_IN_MODULE` | 模块页是 D 级 | D 级是推断和假设,不许进课件。要么补证据升到 C 以上,要么把这段挪进「待验证」区 |
+
+`EVIDENCE_INFLATED` 是这个库最隐蔽的腐化方式:一开始某个 topic 页只用了 1 份讲师经验(C),后来补了 3 份报告,作者顺手把等级改成 A —— 但那 3 份报告本身是 B 级测算,最低级仍是 B。等级只会被最弱的那条拖住。
+
+### 第二梯队(结构问题)
+
+| kind | 含义 | 修法 |
+|---|---|---|
+| `DEAD_LINK` | `[[X]]` 没有对应页面 | 三选一:① 页面名写错了 → 改链接;② 该页还没建 → 建它(有价值时);③ 引用没意义了 → 删掉这句话连同链接 |
+| `ORPHAN` | 无 sources 且无入链 | 孤立的知识碎片。要么挂到某个 topic 的 `related` 里、或在正文被引用;要么它其实是独立主题,那就从 `index.md` 业务地图里给个入口。**实在没价值就归档,别留着占地方** |
+| `NO_FM` / `MISSING_FIELD` | frontmatter 缺失或不完整 | 补齐。`title`/`type`/`summary` 三个必须有,`summary` ≤ 40 字 |
+| `THIN` | 正文 < 100 字 | 补内容,或者合并进别的页。空壳页比没有页更糟——它会让索引显得很丰满,实际查不到东西 |
+
+---
+
+## 修复动作的边界
+
+- ✅ 改正文、补 frontmatter、改链接、合并页面
+- ✅ 把无价值页面移入 `_archive/`
+- ❌ 删原材料
+- ❌ 改 `_index.md`(会被 graph 覆盖,改 frontmatter)
+- ❌ 为了让 lint 数字好看而删问题条目(比如把坏链接删掉但不修内容)——**lint 是体检,不是评分游戏**
+
+---
+
+## 修完必做
+
+```bash
+python 90-工具/kb.py graph && python 90-工具/kb.py lint
+```
+
+分数没回去说明没修到根上。**别在分数没变的情况下汇报"已修复"。**
+
+---
+
+## 定期体检节奏
+
+| 频率 | 检查什么 |
+|---|---|
+| 每次同步后 | 自动跑一次,只看有没有新增问题 |
+| 每周 | 全量 lint + 清 rebuild_queue |
+| 每月 | 看 `topics/_index.md`,找"同一件事拆成好几页"的;看长期没被引用的页,考虑合并;**抽 5 个 topic 页对比数字,看有没有互相打架** |
+| 每季度 | 看 `index.md` 的业务地图是否还反映真实业务;删掉已不再做的业务分区 |
+
+---
+
+## 报告格式
+
+```md
+知识库体检 · 健康分 87/100(黄)
+
+42 页 / 18 源 / 6 个问题 / 2 项待重建
+
+根因(先修这两个)
+1. DANGLING_SOURCE — topics/客户画像.md 引用了已删除的《2025客户访谈.docx》
+   建议:源确实作废 → 跑 retract,用剩余 3 个源重合成
+2. STALE — modules/D2-Agent编排.md 待重建
+
+结构问题
+3. DEAD_LINK ×3 — 都指向 `提示词案例集`(该页已归档)
+   建议:改成直接引用 sources/提示词方法.md
+
+顺手可做
+- THIN — entities/某银行.md 只有 60 字,建议合并进 topics/客户画像
+```

+ 176 - 0
30-技能/kb-query/SKILL.md

@@ -0,0 +1,176 @@
+---
+name: kb-query
+tags: [knowledge-base, retrieval, routing, rag]
+creator: 传鹏
+description: |-
+  知识库检索路由。按"索引 → 摘要 → 全文 → 原文"四级递进定位,用最少的读取回答用户问题,并给出出处与缺口。
+
+  触发词:库里有没有、查一下、找资料、关于XX的资料、知识库里怎么说、之前整理的、有没有写过
+---
+
+# 知识库检索
+
+## 铁律
+
+**禁止一上来 `grep` 全库,更禁止把整个库读一遍。**
+库的规模会长到几百页,暴力检索既慢又容易把不相干的内容混进答案。
+
+按成本从低到高,命中即停:
+
+---
+
+## Level 0 · 业务地图(成本≈0)
+
+读 `10-知识库/index.md` 的「业务地图」段。
+
+用户的问题如果能映射到某个业务分区(市场/客户/内容/交付),直接跳去看那个分区的页面。
+
+命中就停在 Level 1。
+
+---
+
+## Level 1 · 目录索引(成本≈读 200 行)
+
+读对应目录的 `_index.md`:
+
+```
+10-知识库/topics/_index.md      主题结论
+10-知识库/sources/_index.md     原始资料摘要
+10-知识库/entities/_index.md    实体
+10-知识库/modules/_index.md     课程模块
+```
+
+表格里每行有「一句话」和「标签」,扫一遍就知道该读哪几页。
+
+---
+
+## Level 2 · 摘要与标签(成本≈读 frontmatter)
+
+如果 Level 1 没命中,按关键词在 frontmatter 里找:
+
+```bash
+grep -rn "关键词" 10-知识库/*/  --include="*.md" | grep -E "title|summary|tags|aliases"
+```
+
+`aliases` 字段是同义词的藏身处 —— 用户说"内训",页面可能叫"企业培训"。
+
+---
+
+## Level 3 · 全文(成本≈读匹配行)
+
+```bash
+grep -rn "关键词" 10-知识库/ --include="*.md"
+```
+
+只读匹配行 + 前后 3 行,不要整篇读。
+
+---
+
+## Level 4 · 逐页精读(成本最高)
+
+只读 Level 1–3 挑出来的 1–5 页。读的时候注意:
+
+- `stale: true` 的页 → 先看 `stale_reason`,答案里必须提示"这条依据可能已过期"
+- `status: draft` 的页 → 标明"草稿,未经确认"
+- frontmatter 的 `sources` → 这是引用出处
+
+---
+
+## Level 5 · 回原材料(兜底)
+
+知识库是原材料的**加工品**,可能丢细节。如果用户要的是原文措辞、完整数据表、合同条款:
+
+1. 从页面 frontmatter 的 `sources:` 拿到原材料路径
+2. 去 `00-原材料/` 读原文件
+3. 答案里注明"引自原始文件,知识库摘要未覆盖这一层细节"
+
+---
+
+## 库改了怎么办
+
+用户问的东西如果**库里没有**,先别急着说"没有":
+
+```bash
+python 90-工具/kb.py status
+```
+
+如果 `待处理新增 > 0`,说明料在库里但还没整理 —— 这时候应该说:
+
+> "库里还没整理这块,但 `00-原材料/02-客户与需求/` 里有 3 个未入库文件看着相关,我现在同步一下再答?"
+
+而不是"没有相关资料"。
+
+---
+
+## 回答格式
+
+```md
+**结论**
+(先给答案,2–3 句,不要绕)
+
+**依据**
+- 2026 年市场规模 380 亿,增速 42% —— `topics/AI培训市场.md`(源:《2026 AI 培训白皮书》)
+- 客户普遍接受 3 天 2 晚 —— `sources/某银行内训需求.md`
+
+**置信度**
+高 / 中 / 低 + 一句话理由
+
+**缺口**(有才写)
+- 缺 2025 年的对比数据,建议补一份行业年报
+```
+
+**没有出处的内容一律不写进「依据」。** 模型自己的常识如果非要用,单独放一段叫「补充(非库内资料)」。
+
+---
+
+## 第 6 步 · 沉淀(把所有好答案变成库存)
+
+**这一步不做,这个库永远只是原材料的复印件。**
+
+RAG 和 wiki 的根本区别在这里:RAG 每次问都从零拼一遍,答完就没了;wiki 把答过的东西留下来,下次直接引用。
+
+### 什么值得写回
+
+| 值得 | 判断标准 |
+|---|---|
+| 综合了 ≥3 个来源的分析 | 下次再问还要再翻 3 个源,不写就是浪费 |
+| 一次对比、选型、取舍 | 「A 方案还是 B 方案」这类结论最值得留 |
+| 发现了原本没记的关联 | 「原来这个客户和那门课是一回事」 |
+| 会被反复问的问题 | 销售、讲师、新人都会问的那种 |
+
+不值得:一次性事实查询(「那个文件在哪」)、库外常识、还没结论的探索。
+
+### 怎么写回
+
+新建或并入 `10-知识库/topics/<主题>.md`,frontmatter 加一个字段:
+
+```yaml
+derived_from: "query"      # 标记这页源自一次检索,不是从原文件直接整理
+evidence: "C"              # 取所引来源的最低级 —— 检索不会提高证据强度
+```
+
+正文开头注明来路:
+
+```md
+> 本页由 2026-11-04 的一次检索整理而成,依据 `sources/白皮书.md`、`sources/客户访谈.md`。
+> 不是原始结论,是综合判断,引用时请回溯来源。
+```
+
+然后 `kb.py mark` 不用跑(没有新源),但**必须 `kb.py graph`**,否则索引不知道多了这页。
+
+### 沉淀的复利
+
+一个做了半年课的库,应该是:源文件 200 份,知识页 500+,其中至少三分之一是历次问答沉淀下来的。
+
+**只有源、没有沉淀的库,用一年也还是那 200 份文件的目录。**
+
+---
+
+## 常见错误
+
+| 错误 | 后果 |
+|---|---|
+| 把 `_index.md` 的摘要当正文答 | 丢细节,且可能引用过期摘要 |
+| 忽略 `stale` 标记 | 拿作废数据做决策 |
+| 库里没有就编一个 | 做出来的课站不住 |
+| 引用页面但不给出处 | 用户无法复核,失去信任 |

+ 257 - 0
30-技能/kb-sync/SKILL.md

@@ -0,0 +1,257 @@
+---
+name: kb-sync
+tags: [knowledge-base, incremental-ingest, rollback, llm-wiki]
+creator: 传鹏
+description: |-
+  知识库增量同步引擎。扫描原材料目录,识别新增/变更/删除/移动,把新料整理成 md 页面,把被删源派生的页面回滚归档。是整个做课系统新鲜度的保证。
+
+  触发词:同步知识库、同步资料、增量入库、整理新资料、我刚丢了文件、删了源文件、回滚、资料变了、更新知识库
+---
+
+# 知识库增量同步
+
+## 核心原则
+
+> **差异由脚本算,内容由你写,状态由脚本记。**
+> 你唯一不能做的事:凭记忆判断"这个文件是不是新的"。
+
+**幂等性保证**:同一次同步跑两遍,第二遍应该是 `新增 0 · 变更 0 · 删除 0`。如果第二遍还有变化,说明上一次 `mark` 漏了。
+
+---
+
+## 执行流程
+
+### Step 1 · 看现状
+
+```bash
+python 90-工具/kb.py status
+```
+
+记下 `待处理新增` / `待处理删除` / `待重建` 三个数字。这次同步要消掉它们。
+
+### Step 2 · 精确差异
+
+```bash
+python 90-工具/kb.py scan --json
+```
+
+返回五类。**处理顺序必须是:MOVED → DELETED → NEW → CHANGED**。
+理由:先清账再记账。删除不处理就加新料,会导致回滚时误伤。
+
+---
+
+## Step 3 · MOVED(最便宜,先做)
+
+源文件改名或挪目录,内容 hash 没变。
+
+```bash
+python 90-工具/kb.py move "<旧路径>" "<新路径>"
+```
+
+脚本会改 manifest 并把所有页面 frontmatter 里的 `sources:` 引用换掉。**不需要重读文件,不需要改写页面内容。**
+
+可选:如果页面 title / id 里带了旧文件名,顺手改一下 title。
+
+---
+
+## Step 4 · DELETED(回滚,最容易出事)
+
+对每一个 deleted 源:
+
+```bash
+python 90-工具/kb.py retract "<源相对路径>"
+```
+
+脚本自动做三件事,对应三种情形:
+
+| 情形 | 脚本行为 | 你要做的 |
+|---|---|---|
+| **独占页**(该页只有这一个源) | 页面移入 `_archive/`,原位置删除 | 无。归档可回溯 |
+| **共享页**(该页有多个源) | 从 `sources` 移除该源,标 `stale: true`,进 `rebuild_queue` | 用**剩余源**重新合成该页 |
+| **级联**(别的页面引用了被归档页) | 这些页被标 `stale: true` | 判断:改写引用 / 解除引用 / 之后补源 |
+
+### 必须做的收尾
+
+1. **处理 rebuild_queue** —— 读 `_meta/rebuild_queue.jsonl`,对每个页面:
+   - 剩余源还在 → 重读剩余源,重写该页正文,清掉 `stale`
+   - 剩余源也不够了 → 把页面降级为 `status: draft`,正文写明"原依据 X 已移除,以下结论待补充依据"
+2. **处理级联 stale** —— 检查被标 stale 的页面里对已归档页的 `[[引用]]`:
+   - 能改写成直接引用剩余源 → 改写
+   - 不能 → 删掉那一句,别留死链(`lint` 会报 DEAD_LINK)
+3. **不要物理删除** `_archive/` 里的东西。真要清,等用户明确说。
+
+> ⚠️ 用户删源文件的真实意图常常是"这份资料作废了"。如果归档后发现**这门课的产出(20-课程产出/)里引用了作废内容**,必须主动提醒用户,不要默默改完就完事。
+
+---
+
+## Step 5 · NEW(主战场)
+
+### 5.1 先分级,别一把梭
+
+按文件数量决定策略:
+
+| 新文件数 | 策略 |
+|---|---|
+| 1–3 | 全部处理,一次汇报 |
+| 4–20 | 全部处理,但每 5 个汇报一次进度 |
+| > 20 | **先挑 3 个最有代表性的做完给用户看格式**,确认后再批量(避免格式返工 20 次) |
+
+按重要性排序再处理:`02-客户与需求` > `03-课程素材` > `01-行业资料` > `04-竞品参考`。
+
+### 5.2 按类型读取
+
+| 扩展名 | 读法 |
+|---|---|
+| `.md` `.txt` `.csv` `.json` | 直接读 |
+| `.pdf` | 用 `workbuddy-pdf` 技能(文本层优先,扫描件看页面图) |
+| `.docx` `.doc` | 用 `workbuddy-office-routing` |
+| `.xlsx` `.xls` | 用 `workbuddy-sheetagent` |
+| `.pptx` | 用 `workbuddy-pptx` |
+| `.html` `.htm` | 直接读,先剥标签 |
+| `.png` `.jpg` `.webp` | `ViewImage`,提取图中文字与要点 |
+| `.mp3` `.mp4` `.wav` `.m4a` | `AudioTranscribe` 转文字,再整理 |
+| 其他二进制 | 尝试 `python` 提取纯文本;失败则**只登记不解析**,并在 source 页写明"文件类型不支持自动解析,需人工补充" |
+
+### 5.3 值不值得入库(重要判断)
+
+不是每个文件都值得建页。先问三个问题:
+
+1. 它对我们做 AI 企业内训课有用吗?
+2. 里面有可复用的具体信息(数字、方法、案例、客户原话)吗?
+3. 三个月后还会有人想查它吗?
+
+**三个都是否 → 只建一个最小 source 页**,写明"内容与业务相关性低,仅登记备查",不做派生。**不要为了凑数硬编派生页。**
+
+### 5.4 建 source 页
+
+路径:`10-知识库/sources/<去扩展名的文件名>.md`
+
+照 `_meta/约定.md` 的 frontmatter 规范写,`sources:` 填**原材料的相对路径**(精确到一字不差)。
+
+正文骨架:
+```md
+# <标题>
+
+## 这是什么
+(一句话定位:什么机构、什么时间、什么性质的文件)
+
+## 核心内容
+(3–7 条要点,带数字的优先)
+
+## 可引用原句
+> 原话照抄(做课时的弹药,别改写)
+
+## 对做课的价值
+(能用在哪个模块、哪个环节;没有就写"暂未发现")
+```
+
+完成后立刻登记:
+```bash
+python 90-工具/kb.py mark "<源相对路径>" --pages "sources/<页面>.md"
+```
+
+### 5.5 派生页(决定知识库有没有价值的地方)
+
+读完一个源,问:**它能补上哪一块?** 三种产出:
+
+**A. 并入已有 topic 页**(最常见,也最省)
+先 `kb-query` 查有没有相关主题页。有 → 把新事实补进该页,并把该源加进它的 `sources:` 列表。**不要为同一件事开第二个 topic 页。**
+
+**B. 新建 topic 页**
+条件:这个主题在库里还不存在,且预计未来还会不断有新料进来。
+路径 `10-知识库/topics/<主题名>.md`。
+
+**C. 新建 entity / module 页**
+- entity:出现了一个需要反复引用的机构、人物、政策、工具
+- module:这段内容可以直接变成课上的 30–90 分钟单元
+
+**派生后必须补登记**(把新页面加进 mark 的 --pages):
+```bash
+python 90-工具/kb.py mark "<源相对路径>" --pages "sources/x.md,topics/y.md,modules/z.md"
+```
+
+### 5.6 回声检查(一半的价值在这一步)
+
+**新手最容易犯的错:新源进来只建了一个 source 页,然后就走了。**
+
+Karpathy 的实测经验:**一个源入库,平均会触及 10–15 个页面。** 你只建了 1 页,说明漏了回声检查。
+
+入库完,回头问四个问题:
+
+| 问 | 动作 |
+|---|---|
+| 哪些已有 topic 页被这个源补充了? | 把新事实补进去,把源加进它的 `sources` 列表 |
+| 哪些 entity 页的属性变了? | 更新。客户换了决策人、政策出了新版,都是 entity 页的事 |
+| 有没有和已有结论打架? | **登记到 `_meta/矛盾登记.md`,不许静默采用新的** |
+| 有没有让某个 module 的素材变强或变弱? | 更新 module 页。这条**直接影响做课质量** |
+
+怎么找"被触及"的页:
+
+```bash
+grep -rln "<新源里的关键名词>" 10-知识库/topics/ 10-知识库/entities/ 10-知识库/modules/
+```
+
+**自查标准**:如果一个源入库后只新建了 1 页、没改动任何已有页,有两种可能——要么这份料确实孤立(少见),要么你没做回声检查(常见)。
+
+---
+
+## Step 6 · CHANGED(源变了)
+
+同一路径、内容 hash 不同。判断改动幅度:
+
+| 幅度 | 判据 | 处理 |
+|---|---|---|
+| 微调 | 改了几个字/格式 | 更新 source 页对应表述,`updated` 改今天 |
+| 中改 | 增删了一个小节 | 重写 source 页正文,检查派生页有没有依赖被删的内容 |
+| 重写 | 结构全变 | 当作 NEW 处理:重建 source 页,逐条检查所有引用它的派生页 |
+
+派生页检查方法:
+```bash
+grep -rl "<源相对路径>" 10-知识库/*/  # 找所有引用该源的页面
+```
+
+改完刷新指纹:
+```bash
+python 90-工具/kb.py mark "<源相对路径>" --pages "<受影响的页面列表>"
+```
+
+> 若 source 页 frontmatter 里有 `source_sha` 字段,`lint` 会自动比对 manifest 抓出漂移。建议加上。
+
+---
+
+## Step 7 · 收尾(不许省)
+
+```bash
+python 90-工具/kb.py graph   # 重建关系图和所有 _index.md
+python 90-工具/kb.py lint    # 健康检查
+```
+
+**`graph` 之前,用户看到的索引全是旧的。`graph` 之后,索引才是真的。**
+
+lint 有问题就当场修,别攒着:
+- `DEAD_LINK` → 改引用或删引用
+- `DANGLING_SOURCE` → 跑 retract 或补 mark
+- `MISSING_FIELD` → 补 frontmatter
+- `ORPHAN` → 找地方挂链接,或确认它是独立页
+- `SOURCE_DRIFT` → 回到 Step 6
+
+最后更新总索引:如果新增了 topic 页,在 `10-知识库/index.md` 的「业务地图」里挂一行。
+
+---
+
+## Step 8 · 汇报
+
+```md
+同步完成
+
+增量:新增 3 · 变更 1 · 删除 1 · 移动 1
+派生:source 3 页 / topic 2 页 / module 1 页
+回滚:归档 2 页,1 页待重建(已处理)
+健康:92 分,无遗留问题
+
+⚠️ 提醒:删掉的《2024旧版大纲》在 `20-课程产出/AI内训-银行版/大纲.md` 里被引用过,那份课程可能需要复核。
+
+下一步:`topics/客户画像` 目前只有 1 个源,建议补 2 份客户访谈记录再合成。
+```
+
+**必须包含**:做了什么、库变成什么样、有什么风险、下一步建议。不要只说"已完成"。

+ 180 - 0
90-工具/check-content.py

@@ -0,0 +1,180 @@
+# -*- coding: utf-8 -*-
+"""
+check-content.py — 知识库内容质量检查(只管文风与出处,不管结构)
+
+为什么单独一个文件:
+  kb.py lint 查的是「结构对不对」(死链、孤儿、缺字段)。结构对了不等于内容能用。
+  这个脚本查的是「内容能不能直接拿去做课」——AI 腔、长句、没出处的数字。
+  两者职责不同,混在一起以后没人敢改。参照 HowToLiveBetter 的 tools/check-plain.mjs。
+
+怎么用:
+  python 90-工具/check-content.py            列出全部问题,有问题退出码 1(CI / 提交前用)
+  python 90-工具/check-content.py --stat     只按类型计数,不列明细
+  python 90-工具/check-content.py --path 10-知识库/topics   只查某个目录
+
+查三样:
+  ① AI 腔      元叙述、空转加强词、段尾升华、万能开头。词表见 HARD / SOFT。
+  ② 长句       超过 60 字的句子。读者是做课的同事,不是审稿人。
+  ③ 没出处的数字  带 万/亿/%/倍/元 的数字,同一段落里必须能找到脚注、双链或「来源」字样。
+                做课翻车都翻在数字上,结构再完整,一个凭空来的 42% 就毁一门课。
+
+不查什么(故意不查,免得误报多了没人看):
+  - 「3 天 2 晚」「40 人」这类课程设计描述,它们不是统计口径,本来也不需要出处
+  - 「第 3 节第 5 条」这类交叉引用
+  - 代码块、表格、引用块、标题行
+"""
+import sys, re, json, argparse
+from pathlib import Path
+
+if hasattr(sys.stdout, "reconfigure"):
+    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
+
+ROOT = Path(__file__).resolve().parent.parent
+WIKI = ROOT / "10-知识库"
+DIRS = ["sources", "topics", "entities", "modules"]
+
+MAX_SENT = 60
+
+# ① AI 腔:硬伤,见到就改。只收确实反复出现的,宁漏勿滥。
+HARD = [
+    (r"本(页|文|节|章|条|条目)(主要)?(介绍|讲|说|阐述)", "元叙述"),
+    (r"^以上(就)?是", "元叙述"),
+    (r"(这|本)(一)?(条|页|节)(主要)?(讲|说|解决)", "元叙述"),
+    (r"值得注意的是", "空转加强词"),
+    (r"不难发现|不言而喻|众所周知", "空转加强词"),
+    (r"总而言之|综上所述|总的来说|归根结底", "空转加强词"),
+    (r"本质上(就是|是)", "空转加强词"),
+    (r"(在当今|在当前)[^。]{0,20}(背景|形势|环境|时代)下", "万能开头"),
+    (r"随着[^。]{0,15}的(不断|快速|飞速|持续)(发展|进步|推进)", "万能开头"),
+    (r"让我们一起|未来可期|相信在不久的将来|共同拥抱", "段尾升华"),
+]
+# ② 比喻与套话:建议改,不进退出码。它们在商业语境里有时是正常词,机器判断不了。
+SOFT = ["组合拳", "最后一公里", "护城河", "抓住抓手", "顶层设计", "颗粒度对齐",
+        "形成闭环", "打通", "赋能", "生态位", "飞轮"]
+
+# ③ 需要出处的数字:只认统计口径的单位
+NUM_RE = re.compile(r"(\d[\d,]*(?:\.\d+)?)\s*(万|亿|%|%|倍|元)")
+SRC_MARK = re.compile(r"\[\^|\[\[|来源|出处|http|注:|待核实|推测")
+SENT_SPLIT = re.compile(r"[。!?;\n]+")
+
+
+def iter_pages(base: Path):
+    for d in DIRS:
+        p = base / d
+        if not p.exists():
+            continue
+        for f in sorted(p.rglob("*.md")):
+            if f.name.startswith("_"):
+                continue
+            yield f
+
+
+def strip_front_matter(text: str):
+    if text.startswith("---"):
+        m = re.match(r"^---\r?\n.*?\r?\n---\r?\n?", text, re.S)
+        if m:
+            return text[m.end():]
+    return text
+
+
+def check_file(f: Path):
+    """返回 [(kind, lineno, detail)]"""
+    raw = f.read_text(encoding="utf-8", errors="replace")
+    body = strip_front_matter(raw)
+    offset = raw[:len(raw) - len(body)].count("\n")
+    lines = body.splitlines()
+
+    out = []
+    in_code = False
+    para_buf, para_start = [], 0        # 段落缓冲,用于数字出处判断
+
+    def flush_para():
+        if not para_buf:
+            return
+        text = " ".join(para_buf)
+        has_src = bool(SRC_MARK.search(text))
+        for m in NUM_RE.finditer(text):
+            if not has_src:
+                out.append(("数字无出处", para_start,
+                            f"{m.group(1)} {m.group(2)}"))
+
+    for i, line in enumerate(lines):
+        ln = offset + i + 1
+        s = line.strip()
+
+        if s.startswith("```"):
+            in_code = not in_code
+            flush_para(); para_buf = []
+            continue
+        if in_code:
+            continue
+        if not s:
+            flush_para(); para_buf = []
+            continue
+        # 跳过不查的行
+        if s.startswith("#") or s.startswith("|") or s.startswith(">") or s.startswith("<!--"):
+            flush_para(); para_buf = []
+            continue
+
+        if not para_buf:
+            para_start = ln
+        para_buf.append(s)
+
+        # ① 硬伤
+        for pat, name in HARD:
+            m = re.search(pat, s)
+            if m:
+                out.append((name, ln, f"「{m.group(0)}」"))
+        # ② 软提示
+        for w in SOFT:
+            if w in s:
+                out.append(("比喻套话", ln, f"「{w}」建议换成具体动作"))
+        # ③ 长句
+        for sent in SENT_SPLIT.split(s):
+            sent = sent.strip(" -*0123456789.")
+            n = len(re.sub(r"\s", "", sent))
+            if n > MAX_SENT:
+                out.append(("长句", ln, f"{n} 字(上限 {MAX_SENT}):{sent[:24]}…"))
+
+    flush_para()
+    return out
+
+
+def main():
+    ap = argparse.ArgumentParser()
+    ap.add_argument("--stat", action="store_true")
+    ap.add_argument("--json", action="store_true")
+    ap.add_argument("--path", default=None)
+    a = ap.parse_args()
+
+    base = Path(a.path) if a.path else WIKI
+    if not base.is_absolute():
+        base = ROOT / base
+
+    rows, counts, nfile = [], {}, 0
+    for f in iter_pages(base):
+        nfile += 1
+        for kind, ln, detail in check_file(f):
+            rows.append({"file": f.relative_to(ROOT).as_posix(),
+                         "line": ln, "kind": kind, "detail": detail})
+            counts[kind] = counts.get(kind, 0) + 1
+
+    if a.json:
+        print(json.dumps({"files": nfile, "issues": rows, "by_kind": counts},
+                         ensure_ascii=False, indent=2))
+    elif a.stat:
+        print(f"内容检查:{nfile} 个文件," +
+              ("、".join(f"{k} {v}" for k, v in counts.items()) or "无问题"))
+    else:
+        for r in rows:
+            print(f"{r['file']}:{r['line']}  [{r['kind']}] {r['detail']}")
+        print(f"\n内容检查 {nfile} 个文件,{len(rows)} 条问题:" +
+              ("、".join(f"{k} {v}" for k, v in counts.items()) or "干净"))
+
+    # 只让硬伤影响退出码;比喻套话是建议
+    hard = sum(v for k, v in counts.items() if k != "比喻套话")
+    return 1 if hard else 0
+
+
+if __name__ == "__main__":
+    sys.exit(main())

+ 853 - 0
90-工具/kb.py

@@ -0,0 +1,853 @@
+# -*- coding: utf-8 -*-
+"""
+kb.py — 做课系统知识库工具链
+
+所有"客观事实"由本脚本负责:文件指纹、差异计算、关系图、索引重建、健康检查。
+所有"主观判断"由 skill(LLM)负责:抽取、归纳、写页、写摘要。
+
+设计原则:
+  1. 脚本不碰内容语义,只维护结构。
+  2. 幂等:任何命令重复执行结果一致。
+  3. 可回滚:删除先进 _archive,不物理销毁。
+
+用法:
+  python kb.py status
+  python kb.py scan [--json]
+  python kb.py mark <源相对路径> --pages a.md,b.md
+  python kb.py retract <源相对路径>
+  python kb.py move <旧路径> <新路径>
+  python kb.py graph
+  python kb.py lint [--json]
+"""
+import sys, os, json, re, hashlib, shutil, argparse, subprocess
+from pathlib import Path
+from datetime import datetime, timezone, timedelta
+
+if hasattr(sys.stdout, "reconfigure"):
+    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
+
+ROOT = Path(__file__).resolve().parent.parent
+RAW = ROOT / "00-原材料"
+WIKI = ROOT / "10-知识库"
+META = WIKI / "_meta"
+ARCHIVE = WIKI / "_archive"
+MANIFEST = META / "manifest.json"
+DERIV = META / "derivations.jsonl"
+CHANGELOG = META / "changelog.jsonl"
+CHANGELOG_MD = META / "CHANGELOG.md"
+REBUILD = META / "rebuild_queue.jsonl"
+
+CST = timezone(timedelta(hours=8))
+DIRS = ["sources", "topics", "entities", "modules"]
+
+# 原料目录里需要无视的噪声
+NOISE_NAMES = {"desktop.ini", "thumbs.db", ".ds_store", ".gitkeep"}
+NOISE_TAIL = (".tmp", ".crdownload", ".part", ".download", ".swp", ".lock")
+
+
+# ---------------------------------------------------------------- 基础工具
+
+def now() -> str:
+    return datetime.now(CST).isoformat(timespec="seconds")
+
+
+def rel(p: Path, base: Path = None) -> str:
+    """统一成 POSIX 风格相对路径,作为全库唯一键。"""
+    return p.relative_to(base or RAW).as_posix()
+
+
+def sha256(p: Path, chunk: int = 1 << 20) -> str:
+    h = hashlib.sha256()
+    with p.open("rb") as f:
+        for blk in iter(lambda: f.read(chunk), b""):
+            h.update(blk)
+    return h.hexdigest()
+
+
+def short_id(key: str) -> str:
+    return "src_" + hashlib.sha1(key.encode("utf-8")).hexdigest()[:8]
+
+
+def is_noise(p: Path) -> bool:
+    n = p.name
+    if n.startswith(".") or n.startswith("~$"):
+        return True
+    if n.lower() in NOISE_NAMES:
+        return True
+    return n.lower().endswith(NOISE_TAIL)
+
+
+def load_json(p: Path, default):
+    if p.exists():
+        try:
+            return json.loads(p.read_text(encoding="utf-8"))
+        except Exception:
+            pass
+    return default
+
+
+def dump_json(p: Path, obj):
+    p.parent.mkdir(parents=True, exist_ok=True)
+    p.write_text(json.dumps(obj, ensure_ascii=False, indent=2), encoding="utf-8")
+
+
+def append_jsonl(p: Path, row: dict):
+    p.parent.mkdir(parents=True, exist_ok=True)
+    with p.open("a", encoding="utf-8") as f:
+        f.write(json.dumps(row, ensure_ascii=False) + "\n")
+
+
+def read_jsonl(p: Path) -> list:
+    if not p.exists():
+        return []
+    out = []
+    for line in p.read_text(encoding="utf-8").splitlines():
+        line = line.strip()
+        if line:
+            try:
+                out.append(json.loads(line))
+            except Exception:
+                pass
+    return out
+
+
+def log_human(op: str, subject: str, detail: str = ""):
+    """人读日志,与 changelog.jsonl 双写。
+
+    统一前缀是刻意设计:`grep '^## \\[' CHANGELOG.md | tail -5` 就能取最近 5 条,
+    不需要任何工具。这是 Karpathy llm-wiki 里 log.md 的做法,被验证过很好用。
+    """
+    if not CHANGELOG_MD.exists():
+        CHANGELOG_MD.write_text(
+            "# 变更日志\n\n"
+            "> 只增不改。统一前缀便于 shell 检索:\n"
+            "> `grep '^## \\[' CHANGELOG.md | tail -5`\n\n",
+            encoding="utf-8")
+    stamp = datetime.now(CST).strftime("%Y-%m-%d %H:%M")
+    block = f"## [{stamp}] {op} | {subject}\n"
+    if detail:
+        block += detail.rstrip() + "\n"
+    with CHANGELOG_MD.open("a", encoding="utf-8") as f:
+        f.write(block + "\n")
+
+
+# ------------------------------------------------------------ frontmatter
+
+def split_fm(text: str):
+    """返回 (dict, body)。不依赖 pyyaml,只支持本库用到的子集。"""
+    if not text.startswith("---"):
+        return {}, text
+    m = re.match(r"^---\r?\n(.*?)\r?\n---\r?\n?", text, re.S)
+    if not m:
+        return {}, text
+    raw, body = m.group(1), text[m.end():]
+    data, key = {}, None
+    for line in raw.splitlines():
+        if not line.strip() or line.lstrip().startswith("#"):
+            continue
+        if re.match(r"^\s+-\s+", line) and key:
+            if not isinstance(data.get(key), list):
+                data[key] = []
+            data[key].append(_scalar(line.strip()[2:]))
+            continue
+        km = re.match(r"^([A-Za-z_][\w-]*)\s*:\s*(.*)$", line)
+        if km:
+            key, val = km.group(1), km.group(2).strip()
+            if val == "":
+                data[key] = []
+            elif val.startswith("[") and val.endswith("]"):
+                inner = val[1:-1].strip()
+                data[key] = [_scalar(x) for x in inner.split(",")] if inner else []
+            else:
+                data[key] = _scalar(val)
+    return data, body
+
+
+def _scalar(s: str):
+    s = s.strip()
+    if len(s) >= 2 and s[0] == s[-1] and s[0] in "\"'":
+        return s[1:-1]
+    if s.lower() in ("true", "false"):
+        return s.lower() == "true"
+    return s
+
+
+def dump_fm(fm: dict) -> str:
+    order = ["id", "type", "title", "summary", "evidence", "tags", "sources",
+             "related", "status", "stale", "stale_reason", "created", "updated"]
+    keys = [k for k in order if k in fm] + [k for k in fm if k not in order]
+    lines = ["---"]
+    for k in keys:
+        v = fm[k]
+        if isinstance(v, list):
+            if not v:
+                lines.append(f"{k}: []")
+            else:
+                lines.append(f"{k}:")
+                lines += [f"  - {json.dumps(str(x), ensure_ascii=False)}" for x in v]
+        elif isinstance(v, bool):
+            lines.append(f"{k}: {'true' if v else 'false'}")
+        else:
+            lines.append(f"{k}: {json.dumps(str(v), ensure_ascii=False)}")
+    lines.append("---")
+    return "\n".join(lines) + "\n"
+
+
+def read_page(p: Path):
+    text = p.read_text(encoding="utf-8", errors="replace")
+    fm, body = split_fm(text)
+    return fm, body
+
+
+def write_page(p: Path, fm: dict, body: str):
+    p.parent.mkdir(parents=True, exist_ok=True)
+    p.write_text(dump_fm(fm) + body, encoding="utf-8")
+
+
+# ---------------------------------------------------------------- scan
+
+def manifest_skeleton():
+    return {"version": 2, "root": "00-原材料", "updated_at": None,
+            "files": {}, "tombstones": []}
+
+
+def collect_raw() -> dict:
+    """返回 {relpath: {size, mtime_ns, sha256}},大文件用 size+mtime 短路。"""
+    man = load_json(MANIFEST, manifest_skeleton())
+    known = man.get("files", {})
+    out = {}
+    if not RAW.exists():
+        return out
+    for p in sorted(RAW.rglob("*")):
+        if not p.is_file() or is_noise(p):
+            continue
+        r = rel(p)
+        st = p.stat()
+        old = known.get(r, {})
+        if old.get("size") == st.st_size and old.get("mtime_ns") == st.st_mtime_ns and old.get("sha256"):
+            out[r] = {"size": st.st_size, "mtime_ns": st.st_mtime_ns,
+                      "sha256": old["sha256"], "fast": True}
+        else:
+            out[r] = {"size": st.st_size, "mtime_ns": st.st_mtime_ns,
+                      "sha256": sha256(p), "fast": False}
+    return out
+
+
+def cmd_scan(args):
+    man = load_json(MANIFEST, manifest_skeleton())
+    known = man.get("files", {})
+    cur = collect_raw()
+
+    new_keys = sorted(set(cur) - set(known))
+    gone_keys = sorted(set(known) - set(cur))
+    common = sorted(set(cur) & set(known))
+    changed = [k for k in common if cur[k]["sha256"] != known[k].get("sha256")]
+
+    # 移动识别:内容 hash 相同、路径不同
+    gone_by_hash = {}
+    for k in gone_keys:
+        h = known[k].get("sha256")
+        if h:
+            gone_by_hash.setdefault(h, []).append(k)
+    new_by_hash = {}
+    for k in new_keys:
+        new_by_hash.setdefault(cur[k]["sha256"], []).append(k)
+
+    moved, consumed_new, consumed_gone = [], set(), set()
+    for h, news in new_by_hash.items():
+        gones = gone_by_hash.get(h, [])
+        if len(news) == 1 and len(gones) == 1:      # 只在能唯一配对时认定移动
+            moved.append({"from": gones[0], "to": news[0], "sha256": h})
+            consumed_new.add(news[0]); consumed_gone.add(gones[0])
+
+    result = {
+        "generated_at": now(),
+        "new": [k for k in new_keys if k not in consumed_new],
+        "changed": changed,
+        "deleted": [k for k in gone_keys if k not in consumed_gone],
+        "moved": moved,
+        "unchanged": len(common) - len(changed),
+        "details": {k: {"size": cur[k]["size"]} for k in
+                    [*new_keys, *changed] if k in cur},
+    }
+
+    if args.json:
+        print(json.dumps(result, ensure_ascii=False, indent=2))
+        return
+
+    print(f"扫描 {RAW.name}/  @{result['generated_at']}")
+    print(f"  新增 {len(result['new'])} · 变更 {len(result['changed'])} · "
+          f"删除 {len(result['deleted'])} · 移动 {len(result['moved'])} · "
+          f"未变 {result['unchanged']}")
+    for tag, key in (("NEW", "new"), ("CHANGED", "changed"), ("DELETED", "deleted")):
+        for k in result[key]:
+            print(f"  [{tag}] {k}")
+    for m in result["moved"]:
+        print(f"  [MOVED] {m['from']} -> {m['to']}")
+    if not any(result[k] for k in ("new", "changed", "deleted", "moved")):
+        print("  库已是最新,无需同步。")
+
+
+# ---------------------------------------------------------------- mark
+
+def cmd_mark(args):
+    man = load_json(MANIFEST, manifest_skeleton())
+    cur = collect_raw()
+    r = args.path
+    if r not in cur:
+        print(f"[ERR] 原材料中不存在:{r}")
+        return 1
+    pages = [x.strip().replace("\\", "/") for x in (args.pages or "").split(",") if x.strip()]
+    rec = man["files"].get(r, {})
+    rec.update({"size": cur[r]["size"], "mtime_ns": cur[r]["mtime_ns"],
+                "sha256": cur[r]["sha256"], "id": rec.get("id") or short_id(r),
+                "status": "ingested", "ingested_at": now(),
+                "pages": sorted(set(rec.get("pages", []) + pages))})
+    man["files"][r] = rec
+    man["updated_at"] = now()
+    dump_json(MANIFEST, man)
+    append_jsonl(CHANGELOG, {"ts": now(), "op": "ingest", "source": r,
+                             "pages": pages, "sha256": rec["sha256"][:12]})
+    log_human("ingest", r, "\n".join(f"- 派生 `{x}`" for x in pages))
+    print(f"[OK] 已登记 {r} -> {len(pages)} 页")
+
+
+# ---------------------------------------------------------------- retract
+
+def _backlinks(target_keys: set) -> dict:
+    """扫描全库,返回 {被链页面: [引用它的页面]}。用于级联失效。"""
+    links = {}
+    for d in DIRS:
+        for p in (WIKI / d).rglob("*.md"):
+            if p.name.startswith("_"):
+                continue
+            fm, body = read_page(p)
+            for name in set(re.findall(r"\[\[([^\]|#]+)", body)):
+                links.setdefault(name.strip(), []).append(rel(p, WIKI))
+    return links
+
+
+def cmd_retract(args):
+    """源文件被删除后回滚知识库。三种情形:独占页归档 / 共享页降级 / 级联标记。"""
+    src = args.path.replace("\\", "/")
+    man = load_json(MANIFEST, manifest_skeleton())
+    if src not in man["files"]:
+        print(f"[ERR] manifest 中无此源:{src}")
+        return 1
+
+    archived, degraded, cascade = [], [], []
+    touched_stems = set()
+
+    for d in DIRS:
+        for p in sorted((WIKI / d).rglob("*.md")):
+            if p.name.startswith("_"):
+                continue
+            fm, body = read_page(p)
+            srcs = fm.get("sources") or []
+            if not isinstance(srcs, list):
+                srcs = [srcs]
+            if src not in srcs:
+                continue
+            stamped = datetime.now(CST).strftime("%Y%m%d-%H%M%S")
+            if len(srcs) == 1:
+                ARCHIVE.mkdir(parents=True, exist_ok=True)
+                dest = ARCHIVE / f"{p.stem}.{stamped}.md"
+                fm["status"] = "archived"
+                fm["stale_reason"] = f"源文件已删除:{src}"
+                fm["updated"] = now()
+                write_page(dest, fm, body)
+                p.unlink()
+                archived.append(rel(dest, WIKI))
+                touched_stems.add(p.stem)
+            else:
+                fm["sources"] = [s for s in srcs if s != src]
+                fm["stale"] = True
+                fm["stale_reason"] = f"少了一个来源({src}),需重新合成"
+                fm["updated"] = now()
+                write_page(p, fm, body)
+                degraded.append(rel(p, WIKI))
+                append_jsonl(REBUILD, {"ts": now(), "page": rel(p, WIKI),
+                                       "reason": "source_removed", "source": src})
+                touched_stems.add(p.stem)
+
+    # 级联:引用了已归档页面的页面 -> 标记待复核
+    if touched_stems:
+        back = _backlinks(touched_stems)
+        for stem in touched_stems:
+            for ref in back.get(stem, []):
+                fp = WIKI / ref
+                if not fp.exists():
+                    continue
+                fm, body = read_page(fp)
+                if fm.get("stale"):
+                    continue
+                fm["stale"] = True
+                fm["stale_reason"] = f"引用的页面 {stem} 已因源删除而失效"
+                fm["updated"] = now()
+                write_page(fp, fm, body)
+                cascade.append(ref)
+
+    rec = man["files"].pop(src, {})
+    man.setdefault("tombstones", []).append({"path": src, "removed_at": now(),
+                                             "sha256": rec.get("sha256"),
+                                             "pages": rec.get("pages", [])})
+    man["updated_at"] = now()
+    dump_json(MANIFEST, man)
+    append_jsonl(CHANGELOG, {"ts": now(), "op": "retract", "source": src,
+                             "archived": archived, "degraded": degraded,
+                             "cascade": sorted(set(cascade))})
+    log_human("retract", src,
+              "\n".join([f"- 归档 `{x}`" for x in archived] +
+                        [f"- 降级待重建 `{x}`" for x in degraded] +
+                        [f"- 级联标记 `{x}`" for x in sorted(set(cascade))]) or "- 无派生页")
+
+    print(f"[OK] 回滚 {src}")
+    print(f"  归档页 {len(archived)} · 降级为待重建 {len(degraded)} · 级联标记 {len(set(cascade))}")
+    for x in archived:
+        print(f"    ARCHIVE  {x}")
+    for x in degraded:
+        print(f"    DEGRADE  {x}")
+    for x in sorted(set(cascade)):
+        print(f"    CASCADE  {x}")
+    if not archived and not degraded:
+        print("    (该源未派生任何页面,仅清理 manifest)")
+
+
+def cmd_move(args):
+    """源文件移动:sha 相同,只改 manifest 和所有 frontmatter 引用。"""
+    old, new = args.old.replace("\\", "/"), args.new.replace("\\", "/")
+    man = load_json(MANIFEST, manifest_skeleton())
+    if old not in man["files"]:
+        print(f"[ERR] manifest 中无此源:{old}")
+        return 1
+    man["files"][new] = man["files"].pop(old)
+    man["updated_at"] = now()
+    dump_json(MANIFEST, man)
+
+    n = 0
+    for d in DIRS:
+        for p in (WIKI / d).rglob("*.md"):
+            fm, body = read_page(p)
+            srcs = fm.get("sources")
+            if isinstance(srcs, list) and old in srcs:
+                fm["sources"] = [new if s == old else s for s in srcs]
+                fm["updated"] = now()
+                write_page(p, fm, body)
+                n += 1
+    append_jsonl(CHANGELOG, {"ts": now(), "op": "move", "from": old, "to": new})
+    log_human("move", f"{old} -> {new}", f"- 更新引用 {n} 页")
+    print(f"[OK] 移动登记 {old} -> {new},更新引用 {n} 页")
+
+
+# ---------------------------------------------------------------- graph
+
+def all_pages():
+    out = []
+    for d in DIRS:
+        base = WIKI / d
+        if not base.exists():
+            continue
+        for p in sorted(base.rglob("*.md")):
+            if p.name.startswith("_"):
+                continue
+            fm, body = read_page(p)
+            out.append({"path": rel(p, WIKI), "stem": p.stem, "fm": fm,
+                        "body": body, "dir": d})
+    return out
+
+
+def cmd_graph(args):
+    pages = all_pages()
+    edges = []
+    index_map = {p["stem"]: p for p in pages}
+    for p in pages:
+        fm = p["fm"]
+        for s in (fm.get("sources") or []):
+            edges.append({"kind": "derives", "from": str(s), "to": p["path"]})
+        for name in re.findall(r"\[\[([^\]|#]+)", p["body"]):
+            tgt = index_map.get(name.strip())
+            if tgt:
+                edges.append({"kind": "links", "from": p["path"], "to": tgt["path"]})
+
+    DERIV.write_text("".join(json.dumps(e, ensure_ascii=False) + "\n" for e in edges),
+                     encoding="utf-8")
+
+    # 重建各目录 _index.md
+    ts = now()
+    titles = {"sources": "来源页", "topics": "主题页", "entities": "实体页",
+              "modules": "课程模块"}
+    for d in DIRS:
+        group = [p for p in pages if p["dir"] == d]
+        lines = [f"# {titles[d]}索引\n",
+                 f"> 自动生成于 {ts},共 {len(group)} 条。请勿手改,改页面 frontmatter 后重跑 `kb.py graph`。\n"]
+        if not group:
+            lines.append("_(暂无内容)_\n")
+        else:
+            lines.append("| 页面 | 一句话 | 标签 | 源数 | 更新 | 状态 |")
+            lines.append("|---|---|---|---|---|---|")
+            for p in sorted(group, key=lambda x: x["path"]):
+                fm = p["fm"]
+                flag = "⚠️stale" if fm.get("stale") else (fm.get("status") or "ok")
+                lines.append("| [{}]({}) | {} | {} | {} | {} | {} |".format(
+                    fm.get("title") or p["stem"], p["path"],
+                    (fm.get("summary") or "").replace("|", "/"),
+                    ", ".join(fm.get("tags") or []) or "-",
+                    len(fm.get("sources") or []),
+                    str(fm.get("updated") or "")[:10], flag))
+        (WIKI / d / "_index.md").write_text("\n".join(lines) + "\n", encoding="utf-8")
+
+    print(f"[OK] 关系图重建:{len(pages)} 页,{len(edges)} 条边 -> {rel(DERIV, ROOT)}")
+    for d in DIRS:
+        print(f"    {d}/_index.md  ({len([p for p in pages if p['dir']==d])} 条)")
+
+
+# ---------------------------------------------------------------- lint
+
+def cmd_lint(args):
+    pages = all_pages()
+    stems = {p["stem"] for p in pages}
+    aliases = set()
+    for p in pages:
+        for a in (p["fm"].get("aliases") or []):
+            aliases.add(str(a))
+    man = load_json(MANIFEST, manifest_skeleton())
+    live_sources = set(man["files"].keys())
+    inbound = {}
+    for p in pages:
+        for name in re.findall(r"\[\[([^\]|#]+)", p["body"]):
+            inbound.setdefault(name.strip(), []).append(p["path"])
+
+    issues = []
+
+    # 源文件路径 -> 该源的 source 页所标证据等级(用于木桶校验)
+    # 字母序 A<B<C<D,越靠后越弱,所以「最弱」取 max
+    src_ev = {}
+    for p in pages:
+        if p["fm"].get("type") == "source" and p["fm"].get("evidence"):
+            for s in (p["fm"].get("sources") or []):
+                ev = p["fm"]["evidence"]
+                src_ev[s] = max(src_ev[s], ev) if s in src_ev else ev
+
+    for p in pages:
+        fm = p["fm"]
+        if not fm:
+            issues.append(("NO_FM", p["path"], "缺少 frontmatter"))
+            continue
+        for f in ("title", "type", "summary"):
+            if not fm.get(f):
+                issues.append(("MISSING_FIELD", p["path"], f"缺少字段 {f}"))
+        ev = fm.get("evidence")
+        if not ev:
+            issues.append(("MISSING_EVIDENCE", p["path"], "未标证据等级 A/B/C/D"))
+        elif ev not in ("A", "B", "C", "D"):
+            issues.append(("BAD_EVIDENCE", p["path"], f"证据等级非法:{ev}"))
+        else:
+            if fm.get("type") in ("topic", "module"):
+                lows = [src_ev[s] for s in (fm.get("sources") or []) if s in src_ev]
+                weakest = max(lows) if lows else None      # 字母最大 = 证据最弱
+                if weakest and ev < weakest:
+                    issues.append(("EVIDENCE_INFLATED", p["path"],
+                                   f"标了 {ev},但来源最低只有 {weakest}(合成不提升证据强度)"))
+            if fm.get("type") == "module" and ev == "D":
+                issues.append(("D_IN_MODULE", p["path"], "D 级内容不许进课件"))
+        if len(p["body"].strip()) < 100:
+            issues.append(("THIN", p["path"], f"正文过短({len(p['body'].strip())} 字)"))
+        for s in (fm.get("sources") or []):
+            if s not in live_sources:
+                issues.append(("DANGLING_SOURCE", p["path"], f"引用了不存在的源:{s}"))
+        for name in set(re.findall(r"\[\[([^\]|#]+)", p["body"])):
+            if name.strip() not in stems and name.strip() not in aliases:
+                issues.append(("DEAD_LINK", p["path"], f"[[{name.strip()}]] 无对应页"))
+        if not (fm.get("sources") or []) and not inbound.get(p["stem"]):
+            issues.append(("ORPHAN", p["path"], "无来源且无入链"))
+        if fm.get("stale"):
+            issues.append(("STALE", p["path"], fm.get("stale_reason") or "待重建"))
+        if fm.get("type") == "source":
+            src = (fm.get("sources") or [None])[0]
+            if src and man["files"].get(src, {}).get("sha256") and \
+               fm.get("source_sha") and fm["source_sha"] != man["files"][src]["sha256"]:
+                issues.append(("SOURCE_DRIFT", p["path"], "源文件已变更,页面需重新整理"))
+
+    pend = read_jsonl(REBUILD)
+    summary = {
+        "pages": len(pages), "sources": len(live_sources),
+        "issues": len(issues),
+        "by_kind": {},
+        "rebuild_queue": len(pend),
+        "score": max(0, 100 - len(issues) * 3 - len(pend) * 2),
+    }
+    for k, _, _ in issues:
+        summary["by_kind"][k] = summary["by_kind"].get(k, 0) + 1
+
+    if args.json:
+        print(json.dumps({"summary": summary,
+                          "issues": [{"kind": k, "page": p, "detail": d} for k, p, d in issues]},
+                         ensure_ascii=False, indent=2))
+        return
+
+    print(f"健康分 {summary['score']}/100 · {len(pages)} 页 · {len(live_sources)} 源 · "
+          f"{len(issues)} 问题 · {len(pend)} 项待重建")
+    if issues:
+        print("\n按类型:")
+        for k, v in sorted(summary["by_kind"].items(), key=lambda x: -x[1]):
+            print(f"  {k:<18} {v}")
+        print("\n明细:")
+        for k, p, d in issues:
+            print(f"  [{k}] {p} — {d}")
+    else:
+        print("未发现问题。")
+
+
+# ---------------------------------------------------------------- status
+
+def cmd_status(args):
+    man = load_json(MANIFEST, manifest_skeleton())
+    pages = all_pages()
+    pend = read_jsonl(REBUILD)
+    logs = read_jsonl(CHANGELOG)
+    cur = collect_raw()
+    pending_new = set(cur) - set(man["files"])
+    pending_gone = set(man["files"]) - set(cur)
+    stale = [p["path"] for p in pages if p["fm"].get("stale")]
+
+    print("=" * 56)
+    print(" 做课系统 · 知识库状态")
+    print("=" * 56)
+    print(f" 根目录      {ROOT}")
+    print(f" 最近同步    {man.get('updated_at') or '从未'}")
+    print(f" 原料文件    {len(cur)} 个(已整理 {len(man['files'])})")
+    print(f" 知识页      {len(pages)} 页")
+    for d in DIRS:
+        print(f"    {d:<10} {len([p for p in pages if p['dir']==d])}")
+    print(f" 待处理新增  {len(pending_new)}")
+    print(f" 待处理删除  {len(pending_gone)}")
+    print(f" 待重建      {len(pend)}")
+    print(f" 陈旧页      {len(stale)}")
+    print(f" 历史操作    {len(logs)} 条")
+    if pending_new:
+        print("\n 未入库:")
+        for x in sorted(pending_new)[:12]:
+            print(f"    + {x}")
+        if len(pending_new) > 12:
+            print(f"    ... 还有 {len(pending_new)-12} 个")
+    if pending_gone:
+        print("\n 源已消失(待回滚):")
+        for x in sorted(pending_gone)[:12]:
+            print(f"    - {x}")
+    if stale:
+        print("\n 陈旧页:")
+        for x in stale[:12]:
+            print(f"    ! {x}")
+    print("=" * 56)
+    if pending_new or pending_gone or pend:
+        print(" → 建议运行:kb-sync")
+    else:
+        print(" → 库是干净的")
+
+
+# ---------------------------------------------------------------- guide
+
+def cmd_guide(args):
+    """给 AI 的自描述入口(对应 llmwiki 的 guide 工具)。
+
+    为什么要它:每次新会话,AI 都要重建对这套系统的认知。让它读 README 加 8 个
+    SKILL.md,要烧掉几万 token,读完还不一定知道"现在该干什么"。
+    这个命令一次给全:这是什么、铁律是什么、当前什么状态、下一步做什么。
+    """
+    man = load_json(MANIFEST, manifest_skeleton())
+    pages = all_pages()
+    cur = collect_raw()
+    pend_new = sorted(set(cur) - set(man["files"]))
+    pend_gone = sorted(set(man["files"]) - set(cur))
+    stale = [p["path"] for p in pages if p["fm"].get("stale")]
+    nreb = len(read_jsonl(REBUILD))
+
+    print("=" * 60)
+    print(" 做课系统 · 给接手者的指南")
+    print("=" * 60)
+    print("""
+【这是什么】
+  一条单向管道:
+    00-原材料/  ──你整理──▶  10-知识库/  ──取材──▶  20-课程产出/
+    (只进不改)            (全 md,你维护)        (交付物)
+  人是资料策展人,你是维护者。人不写知识库,你写。
+
+【三条铁律】
+  1. 差异问脚本,别凭记忆 —— 判断哪些文件是新的,永远跑 kb.py scan
+  2. 脚本管事实,你管语义 —— 页数、hash、关系图都问脚本
+  3. 补料不许编,取材必标出处 —— 这是两条方向相反的规则,见 AGENTS.md
+
+【该走哪条路】
+  丢进了新资料 / 删了源文件    → 30-技能/kb-sync       (先 scan 再分流)
+  查点东西                    → 30-技能/kb-query      (好答案记得沉淀回库)
+  要做一门课                  → 30-技能/course-outline → course-slides
+  库看着有点乱                → kb.py check           (结构 + 内容一起过)
+  改页面格式或加规则          → 10-知识库/_meta/约定.md(改完登记起因)
+
+【格式硬约束】(细节见 约定.md)
+  每页 frontmatter 必填:type / title / summary / evidence / sources
+  evidence 只能是 A/B/C/D,且 topic、module 页不得高于其来源最低级
+  sources 填原材料相对路径,一字不差 —— 这是删除回滚的唯一依据
+""")
+    print("-" * 60)
+    print("【当前状态】")
+    print(f"  原料 {len(cur)} 个(已整理 {len(man['files'])})· "
+          f"知识页 {len(pages)} 页 · 最近同步 {man.get('updated_at') or '从未'}")
+    for d in DIRS:
+        n = len([p for p in pages if p["dir"] == d])
+        if n:
+            print(f"    {d:<10} {n}")
+    print(f"  待处理新增 {len(pend_new)} · 待处理删除 {len(pend_gone)} · "
+          f"待重建 {nreb} · 陈旧页 {len(stale)}")
+
+    print("\n【下一步】")
+    todo = []
+    if pend_new:
+        todo.append(f"有 {len(pend_new)} 个新源未入库 → kb-sync")
+    if pend_gone:
+        todo.append(f"有 {len(pend_gone)} 个源已消失 → kb-sync 的 retract 分支")
+    if nreb:
+        todo.append(f"有 {nreb} 页待重建 → 读 _meta/rebuild_queue.jsonl")
+    if stale:
+        todo.append(f"有 {len(stale)} 页被标 stale → 处理完记得清标记")
+    if not pages:
+        todo.append("库还是空的 → 把资料丢进 00-原材料/,然后说「同步知识库」")
+    if not todo:
+        todo.append("库是干净的 → 可以说「做一门课」或「查 XX」")
+    for t in todo:
+        print(f"  · {t}")
+    print("=" * 60)
+
+
+# ---------------------------------------------------------------- repair
+
+def cmd_repair(args):
+    """从磁盘现状 + 页面 frontmatter 反推 manifest。
+
+    什么时候用:
+      1. git 合并把 manifest.json 搞冲突了
+      2. manifest 被误删、或从别处只拷了页面没拷 _meta
+      3. 换机器接手
+
+    能恢复什么:每个源的指纹、它派生了哪些页、已整理/未整理状态。
+    恢复不了什么:整理的具体时间(只能留空)、删除过的源记录(tombstone 会丢)。
+    """
+    cur = collect_raw()
+    derived = {}
+
+    # 活跃页 + 归档页都算 —— 归档页的 sources 仍然说明"这个源整理过"
+    scan_roots = [WIKI / d for d in DIRS]
+    if ARCHIVE.exists():
+        scan_roots.append(ARCHIVE)
+
+    for root in scan_roots:
+        if not root.exists():
+            continue
+        for p in sorted(root.rglob("*.md")):
+            if p.name.startswith("_"):
+                continue
+            fm, _ = read_page(p)
+            for s in (fm.get("sources") or []):
+                near = p if p.parent != ARCHIVE else ARCHIVE / p.name
+                derived.setdefault(str(s), []).append(rel(near, WIKI))
+
+    old = load_json(MANIFEST, manifest_skeleton())
+    files, orphan_disk, orphan_pages = {}, [], []
+
+    for r, meta in cur.items():
+        ps = sorted(set(derived.pop(r, [])))
+        prev = old.get("files", {}).get(r, {})
+        files[r] = {
+            "size": meta["size"], "mtime_ns": meta["mtime_ns"],
+            "sha256": meta["sha256"], "id": prev.get("id") or short_id(r),
+            "status": "ingested" if ps else "pending",
+            "ingested_at": prev.get("ingested_at"),
+            "pages": ps,
+        }
+        if not ps:
+            orphan_disk.append(r)
+
+    # 页面引用了磁盘上不存在的源
+    for s, ps in derived.items():
+        orphan_pages.extend(ps)
+
+    man = {"version": 2, "root": "00-原材料", "updated_at": now(),
+           "files": files, "tombstones": old.get("tombstones", [])}
+    dump_json(MANIFEST, man)
+    log_human("repair", f"重建 manifest:{len(files)} 个源",
+              f"- 已整理 {len(files)-len(orphan_disk)} 个,未整理 {len(orphan_disk)} 个")
+
+    print(f"[OK] manifest 已重建:{len(files)} 个源")
+    print(f"  已整理 {len(files)-len(orphan_disk)} · 未整理 {len(orphan_disk)}")
+    if orphan_disk:
+        print(f"\n  磁盘上有、但没派生任何页(下次同步会当新的处理):")
+        for x in orphan_disk[:10]:
+            print(f"    · {x}")
+        if len(orphan_disk) > 10:
+            print(f"    ... 还有 {len(orphan_disk)-10} 个")
+    if orphan_pages:
+        print(f"\n  ⚠️ 有 {len(set(orphan_pages))} 个页面引用了磁盘上已不存在的源")
+        print(f"     → 跑 kb.py lint 看 DANGLING_SOURCE,再决定恢复文件还是 retract")
+
+
+# ---------------------------------------------------------------- check
+
+def cmd_check(args):
+    """聚合器:结构检查(本文件)+ 内容检查(check-content.py)。
+    两个检查器各自独立可跑,这里是给"提交前一次过"用的。"""
+    cmd_lint(argparse.Namespace(json=False))
+    print("\n" + "-" * 56)
+    script = ROOT / "90-工具" / "check-content.py"
+    if not script.exists():
+        print("(未找到 check-content.py,跳过内容检查)")
+        return 0
+    r = subprocess.run([sys.executable, str(script)],
+                       capture_output=True, text=True,
+                       encoding="utf-8", errors="replace")
+    print(r.stdout.strip() or r.stderr.strip()[:800])
+    return 0 if r.returncode == 0 else 1
+
+
+# ---------------------------------------------------------------- main
+
+def main():
+    ap = argparse.ArgumentParser(prog="kb", description="做课系统知识库工具链")
+    sub = ap.add_subparsers(dest="cmd")
+
+    sub.add_parser("status", help="总览")
+    sub.add_parser("guide", help="给 AI 的自描述指南")
+    s = sub.add_parser("scan", help="扫描原料目录,输出差异")
+    s.add_argument("--json", action="store_true")
+
+    m = sub.add_parser("mark", help="登记某源已整理")
+    m.add_argument("path")
+    m.add_argument("--pages", default="")
+
+    r = sub.add_parser("retract", help="源删除后回滚")
+    r.add_argument("path")
+
+    mv = sub.add_parser("move", help="登记源文件移动")
+    mv.add_argument("old")
+    mv.add_argument("new")
+
+    sub.add_parser("graph", help="重建关系图与索引")
+
+    l = sub.add_parser("lint", help="结构健康检查")
+    l.add_argument("--json", action="store_true")
+
+    sub.add_parser("check", help="全量检查:结构 + 内容")
+
+    sub.add_parser("repair", help="从磁盘和页面反推 manifest(git 冲突后用)")
+
+    args = ap.parse_args()
+    fn = {"status": cmd_status, "guide": cmd_guide, "scan": cmd_scan, "mark": cmd_mark,
+          "retract": cmd_retract, "move": cmd_move, "graph": cmd_graph,
+          "lint": cmd_lint, "check": cmd_check, "repair": cmd_repair}.get(args.cmd)
+    if not fn:
+        ap.print_help()
+        return 0
+    return fn(args) or 0
+
+
+if __name__ == "__main__":
+    sys.exit(main())

+ 136 - 0
90-工具/register_skills.py

@@ -0,0 +1,136 @@
+# -*- coding: utf-8 -*-
+"""
+register_skills.py — 把 30-技能/ 下的技能注册给 WorkBuddy
+
+优先用目录联接(junction),改源即生效;失败则回退为复制 + 同步模式。
+
+用法:
+  python register_skills.py            # 注册(link 优先)
+  python register_skills.py --copy     # 强制复制模式
+  python register_skills.py --sync     # 复制模式下,把源文件同步到目标
+  python register_skills.py --status   # 查看当前注册状态
+  python register_skills.py --uninstall
+"""
+import sys, os, shutil, subprocess, argparse
+from pathlib import Path
+
+if hasattr(sys.stdout, "reconfigure"):
+    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
+
+ROOT = Path(__file__).resolve().parent.parent
+SRC = ROOT / "30-技能"
+DEST = Path(os.environ.get("USERPROFILE", Path.home())) / ".workbuddy" / "skills"
+SKILLS = ["course-factory", "kb-sync", "kb-ingest", "kb-query",
+          "kb-lint", "kb-index", "course-outline", "course-slides"]
+
+
+def is_link(p: Path) -> bool:
+    if p.is_symlink():
+        return True
+    try:
+        return bool(p.exists() and os.readlink(str(p)))
+    except (OSError, ValueError):
+        pass
+    # Windows junction 无 readlink,用 FILE_ATTRIBUTE_REPARSE_POINT 判断
+    try:
+        return bool(os.stat(str(p)).st_file_attributes & 0x400)
+    except (AttributeError, OSError):
+        return False
+
+
+def make_link(src: Path, dst: Path) -> bool:
+    if os.name == "nt":
+        r = subprocess.run(["cmd", "/c", "mklink", "/J", str(dst), str(src)],
+                           capture_output=True, text=True,
+                           encoding="gbk", errors="replace")
+        return r.returncode == 0
+    try:
+        dst.symlink_to(src, target_is_directory=True)
+        return True
+    except OSError:
+        return False
+
+
+def register(mode: str):
+    DEST.mkdir(parents=True, exist_ok=True)
+    ok_link, ok_copy = [], []
+    for name in SKILLS:
+        s = SRC / name
+        d = DEST / name
+        if not (s / "SKILL.md").exists():
+            print(f"  [SKIP] {name}:源目录缺少 SKILL.md")
+            continue
+        if d.exists() or is_link(d):
+            if is_link(d):
+                print(f"  [OK]   {name}(已是联接,跳过)")
+                ok_link.append(name)
+                continue
+            shutil.rmtree(d, ignore_errors=True)
+        if mode == "link" and make_link(s, d):
+            print(f"  [LINK] {name}")
+            ok_link.append(name)
+        else:
+            shutil.copytree(s, d)
+            print(f"  [COPY] {name}")
+            ok_copy.append(name)
+    print(f"\n注册完成:联接 {len(ok_link)} 个,复制 {len(ok_copy)} 个 -> {DEST}")
+    if ok_copy:
+        print("提示:复制模式改了源文件后需运行 python register_skills.py --sync")
+
+
+def sync():
+    n = 0
+    for name in SKILLS:
+        s, d = SRC / name, DEST / name
+        if is_link(d) or not d.exists():
+            continue
+        for f in s.rglob("*"):
+            if f.is_file():
+                t = d / f.relative_to(s)
+                t.parent.mkdir(parents=True, exist_ok=True)
+                shutil.copy2(f, t)
+                n += 1
+    print(f"已同步 {n} 个文件到 {DEST}")
+
+
+def status():
+    print(f"技能源目录:{SRC}")
+    print(f"注册目标:  {DEST}\n")
+    for name in SKILLS:
+        d = DEST / name
+        if not d.exists():
+            st = "未注册"
+        elif is_link(d):
+            st = "联接"
+        else:
+            st = "复制(需 sync)"
+        print(f"  {name:<18} {st}")
+
+
+def uninstall():
+    for name in SKILLS:
+        d = DEST / name
+        if is_link(d):
+            subprocess.run(["cmd", "/c", "rmdir", str(d)], capture_output=True,
+                           text=True, encoding="gbk", errors="replace")
+            print(f"  [RM] {name}")
+        elif d.exists():
+            shutil.rmtree(d, ignore_errors=True)
+            print(f"  [RM] {name}")
+
+
+if __name__ == "__main__":
+    ap = argparse.ArgumentParser()
+    ap.add_argument("--copy", action="store_true")
+    ap.add_argument("--sync", action="store_true")
+    ap.add_argument("--status", action="store_true")
+    ap.add_argument("--uninstall", action="store_true")
+    a = ap.parse_args()
+    if a.status:
+        status()
+    elif a.sync:
+        sync()
+    elif a.uninstall:
+        uninstall()
+    else:
+        register("copy" if a.copy else "link")

+ 25 - 0
AGENTS.md

@@ -0,0 +1,25 @@
+# AGENTS.md
+
+这个仓库是公司的**做课系统**:原材料进库 → LLM 整理成知识库 → 从库里取材做课。
+
+先判断你要干哪件事,两边规则不一样:
+
+- **补料**(加资料、整理、删源、修知识库):规则全在 [`10-知识库/_meta/约定.md`](10-知识库/_meta/约定.md),**先读完再动手**;流程见 [`30-技能/kb-sync/SKILL.md`](30-技能/kb-sync/SKILL.md)。
+- **取材**(做课、查资料、出大纲、做课件):见 [`30-技能/course-outline/SKILL.md`](30-技能/course-outline/SKILL.md) 与 [`30-技能/kb-query/SKILL.md`](30-技能/kb-query/SKILL.md)。
+
+**两边的铁律正好相反:**
+
+| | 补料 | 取材 |
+|---|---|---|
+| 能不能补充原文件没有的内容 | **不能**。只允许把原文件里有的东西搬进库 | **能**。可以组合、提炼、编排 |
+| 出处 | 必须能指回具体原文件的哪一段 | 每个数字和结论必须标 `[^脚注]` 或 `[[页面]]` |
+| 缺料时 | 标「待核实」,不许猜 | 明说「库里没有」,不许编 |
+| 证据等级 | 按原文件性质如实定 A/B/C/D | 不得高于所用素材的最低级 |
+
+不确定走哪条,先跑:
+
+```bash
+python 90-工具/kb.py status
+```
+
+这个文件叫 AGENTS.md 只是因为各家 AI 工具默认读这个名字,内容与工具无关。

+ 185 - 0
README.md

@@ -0,0 +1,185 @@
+# 做课系统
+
+> 一个用 llm-wiki 思路管理的课程开发知识库。
+> 原料丢进来 → LLM 整理成结构化 md → 从库里取材做课。
+> 库里所有东西都能追回原始文件,源文件删了会自动回滚。
+
+---
+
+## 它解决什么问题
+
+| 你的痛点 | 这个系统的答案 |
+|---|---|
+| 资料散在微信、桌面、网盘,做课时找不到 | 唯一输入区 `00-原材料/`,全部分类归档 |
+| 每次做课都要重新翻一遍全部资料 | 一次整理成 md 知识库,下次直接检索 |
+| 不知道哪些资料已经整理过、哪些是新的 | `manifest.json` 记指纹,`kb.py scan` 精确算出增量 |
+| 整理过一次就过期了,没人知道 | 源自带 hash,源变了页面自动标 stale |
+| 删了源文件,知识库里留一堆僵尸内容 | `kb.py retract` 三档回滚(归档/降级/级联) |
+| 新人接手,不知道从哪看起 | 三层索引:业务地图 → 目录索引 → 页面摘要 |
+| 做出来的课是"AI 编的",经不起追问 | 每个模块必须标素材出处,缺料就明说 |
+| 课上被问"这个数据哪来的"答不上 | 每页标证据等级 A/B/C/D,做课按等级配比,B 级不许说成 A 级 |
+| 知识库越写越像 AI 生成的垃圾 | 独立的内容检查器查 AI 腔、长句、没出处的数字 |
+
+---
+
+## 结构
+
+```
+做课系统/
+├─ 00-原材料/          【唯一输入区】只进不改,不限文件类型
+│   ├─ _inbox/         随手丢,同步时再分流
+│   ├─ 01-行业资料/
+│   ├─ 02-客户与需求/
+│   ├─ 03-课程素材/
+│   └─ 04-竞品与参考/
+│
+├─ 10-知识库/          【管理目录】全 md,LLM 维护,人可读
+│   ├─ index.md        业务地图(路由入口)
+│   ├─ _meta/          manifest / 关系图 / 日志 / 约定
+│   ├─ _archive/       因源删除而归档的页(可回溯)
+│   ├─ sources/        一源一页
+│   ├─ topics/         多源合成的主题结论
+│   ├─ entities/       人/机构/工具/政策/术语
+│   └─ modules/        可进课表的课程模块
+│
+├─ 20-课程产出/        【交付区】按课程分目录
+├─ 30-技能/            【方法区】8 个 skill
+└─ 90-工具/kb.py       【引擎】管结构,不管语义
+```
+
+---
+
+## 四条核心机制
+
+### 1. 增量:靠指纹,不靠记忆
+
+`00-原材料/` 每个文件在 `_meta/manifest.json` 里有一条记录(size + mtime + sha256)。
+
+```
+scan → 分类
+  NEW       manifest 没有,磁盘有     → 整理成页面
+  CHANGED   hash 变了                  → 重读、更新页面
+  DELETED   manifest 有,磁盘没了      → 回滚
+  MOVED     hash 相同但路径变了        → 只改引用,不重做
+  UNCHANGED 都没变                     → 跳过
+```
+
+大文件用 `size + mtime` 短路,不变就不重算 hash —— 200 页的库扫描一次 1 秒内。
+
+**为什么不能靠 LLM 记忆判断增量**:上下文会丢、会话会断、多人协作时互相不知道。指纹存在磁盘上,谁来跑结果都一样。
+
+### 2. 回滚:三种情形,三种处理
+
+页面 frontmatter 里的 `sources:` 就是回滚依据。删一个源:
+
+| 页面类型 | 判据 | 处理 |
+|---|---|---|
+| **独占页** | `sources` 只有这一个 | 移入 `_archive/`,原位置删除(不物理销毁) |
+| **共享页** | `sources` 有多个 | 移除该源,标 `stale`,进 `rebuild_queue` 等重合成 |
+| **级联页** | 引用了被归档的页 | 标 `stale`,提示人工复核 |
+
+**为什么不直接删**:一个 topic 页可能综合了 5 份资料。删其中 1 份就删整页,等于把另外 4 份的成果也扔了。
+
+### 3. 索引:三层,越往下越贵
+
+```
+L1  index.md 业务地图      按业务问题分区(市场/客户/内容/交付)
+L2  */_index.md 目录索引    自动生成,一行一页带摘要
+L3  frontmatter.summary    写页时顺手写
+```
+
+查东西从上往下走,命中即停。不许一上来全文 grep。
+
+### 4. 可信度:每页标证据等级
+
+| 等级 | 什么内容 | 课上怎么讲 |
+|---|---|---|
+| **A** | 一手数据,口径明确可核对 | 直接讲,标出处 |
+| **B** | 有报告支撑但口径不明/样本小 | 说「某机构测算」 |
+| **C** | 从业者经验、行业共识 | 说「我们的经验是」,不当结论 |
+| **D** | 推断、假设、未验证 | **不上课件** |
+
+**木桶规则**:页面的等级取它所有内容里最弱的那条。topic 页不得高于它来源的最低级——合成不会提高证据强度。
+
+**做课配比**:讲授内容 A+B 不低于 60%。低于 40% 就得改定位,别包装成有数据支撑的课。
+
+这条是"课经不经得起追问"的唯一量化保证。学员里总有一个人会问"这个 42% 哪来的"。
+
+---
+
+## 快速开始
+
+### 第一次
+
+```bash
+cd 做课系统
+python 90-工具/kb.py status        # 应该显示全 0
+```
+
+把第一批资料丢进 `00-原材料/01-行业资料/`,然后对 AI 说:
+
+> 同步知识库
+
+### 日常
+
+```
+丢文件 → 说"同步"     → 增量整理
+删文件 → 说"同步"     → 自动回滚
+找东西 → 说"查 XX"    → 路由检索
+做课   → 说"做一门 XX 课" → 取材出大纲
+体检   → 说"检查知识库"  → lint 修复
+```
+
+### 命令速查
+
+```bash
+python 90-工具/kb.py status              # 总览
+python 90-工具/kb.py scan                # 差异
+python 90-工具/kb.py scan --json         # 差异(给程序用)
+python 90-工具/kb.py mark <源> --pages a.md,b.md   # 登记已整理
+python 90-工具/kb.py retract <源>        # 回滚
+python 90-工具/kb.py move <旧> <新>      # 登记移动
+python 90-工具/kb.py graph               # 重建索引与关系图
+python 90-工具/kb.py lint [--json]       # 结构检查(死链/孤儿/缺字段/等级虚高)
+python 90-工具/check-content.py          # 内容检查(AI 腔/长句/没出处的数字)
+python 90-工具/kb.py check               # 上面两个一起跑,提交前用
+```
+
+---
+
+## 8 个技能
+
+| 技能 | 管什么 |
+|---|---|
+| `course-factory` | **总入口**:激活、诊断、分流、维护编排 |
+| `kb-sync` | 增量同步编排(新增/变更/删除/移动) |
+| `kb-ingest` | 单源精读与原子化(一文件拆几页、怎么命名) |
+| `kb-query` | 五级检索路由 |
+| `kb-lint` | 健康检查与分派修复 |
+| `kb-index` | 索引与业务地图维护、合并/拆分 |
+| `course-outline` | 需求澄清 → 取材 → 大纲 → 模块详案 → 缺口 |
+| `course-slides` | 大纲 → 授课 PPT + 讲师备注 |
+
+---
+
+## 四条不变的规定
+
+1. **原材料只进不改。** 要更新资料,放新版本进去,让系统识别为 NEW。
+2. **写完必登记。** `kb.py mark` 漏一次,下次白干一遍。
+3. **脚本管事实,LLM 管语义。** 任何"哪些文件是新的""有几页"的判断,一律问脚本。
+4. **每页必标证据等级,不许虚高。** 补料时随手把 C 级标成 A 级,三个月后做课就会把它当事实讲给客户。这是这套系统里唯一无法靠工具完全兜住的地方——`EVIDENCE_INFLATED` 只能查"比来源高",查不出"来源本身标错了"。
+
+---
+
+## 扩展
+
+- **加新分类**:在 `00-原材料/` 下建目录即可,`kb.py` 自动纳入扫描。
+- **加新技能**:在 `30-技能/` 下建目录写 SKILL.md,然后在 `course-factory` 的分流表里加一行。
+- **改页面格式**:改 `10-知识库/_meta/约定.md`,同时改 `kb.py` 里 `dump_fm` 的字段顺序,并在约定.md 文末「规则变更记录」登记日期和起因。
+- **加检查规则**:**一个检查器只查一件事**。结构问题进 `kb.py lint`,内容问题进 `check-content.py`,互不掺和。新规则先想清楚:误报率多高?高的就别进退出码,做成 `--xxx` 手动开关。误报多了大家就不看报告了,等于没有检查。
+- **多人协作**:`git init` 后,原材料目录天然适合并行(只增不删),知识库靠 `kb-sync` 收敛。冲突时以 manifest 为准。提交前跑 `kb.py check`。
+
+## 两条给未来的自己的话
+
+1. **每条规则都登记起因。** `约定.md` 文末的变更记录不是形式主义。没有起因的规则,三个月后会被当成官僚条款删掉,然后同一个坑再踩一次。
+2. **检查器宁可漏,不可误报。** 一份没人看的检查报告,比没有检查更糟——它给你一种"有人在管"的错觉。

二進制
_assets/pipeline.png


文件差異過大導致無法顯示
+ 374 - 0
设计说明.html


部分文件因文件數量過多而無法顯示